SocialDog × AI
投稿日2026.09.18
更新日2026.09.18
SocialDog × AIで、自社のクチコミを分析する(誰が・何を語っているか編)
SocialDogのキーワードモニターで集めたクチコミCSVファイルとAIを組み合わせ、「誰が・何を・どんなトーンで自社を語っているか」を可視化するHTMLレポートを自動作成する方法を、実際に使っているプロンプト付きで公開します。

SNSには、アンケートでは拾えない「自社に対する本音」が毎日投稿されています。ただ、その投稿をひとつずつ眺めても、全体としてどんな評価をされているのかまではなかなか見えてきません。
SocialDogの「キーワードモニター」機能とAIを組み合わせると、自社名・ブランド名・商品名で集めたクチコミを、誰が・何を・どんなトーンで語っているかという切り口で集計・可視化したレポートを自動で作成できます。この記事では、実際の運用で使っている2つのプロンプトを、そのまま公開します。
※本記事ではAnthropicの生成AI「Claude」を使用しております。他のAIツールでも応用は可能ですが、出力結果の再現性やプロンプトとの相性を考慮し、Claudeのご利用を推奨します。
【はじめに】SocialDog × AIのクチコミ分析は2種類あります
SocialDogのデータを使ったクチコミ分析には、目的の異なる2つの方法があります。本記事はパターンA(キーワードモニター編)です。
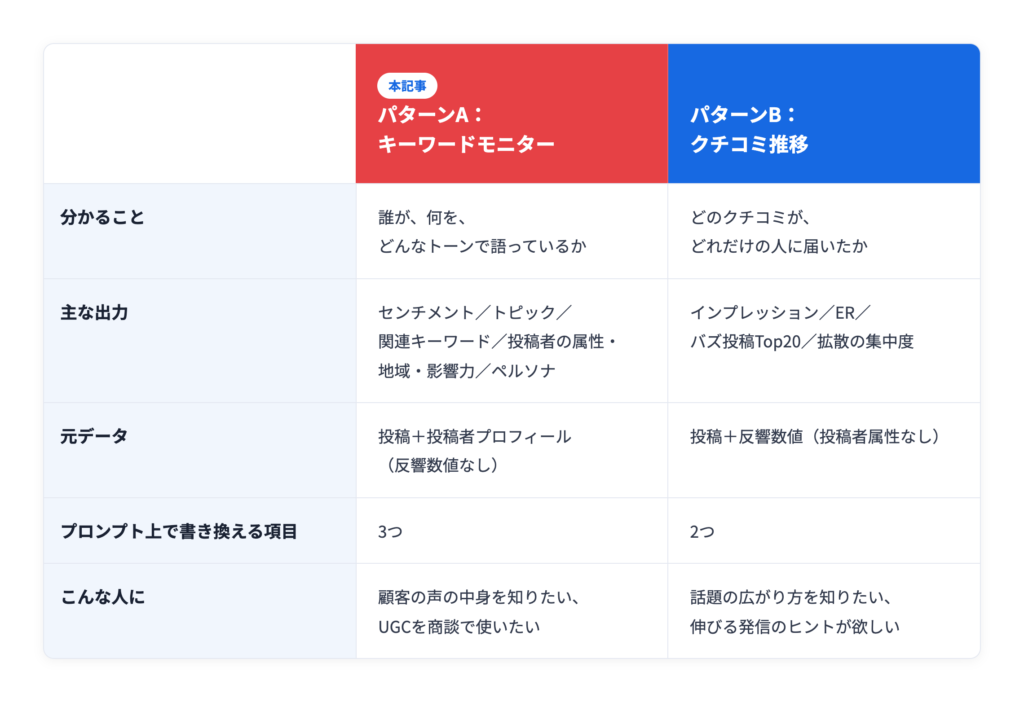
クチコミがどれだけ拡散したかを知りたい場合は、「SocialDog × AIで、クチコミがどれだけ届いたかを分析する(拡散・リーチ編)」をご覧ください。
1. STEP1:SocialDogでクチコミを収集し、CSVダウンロードする
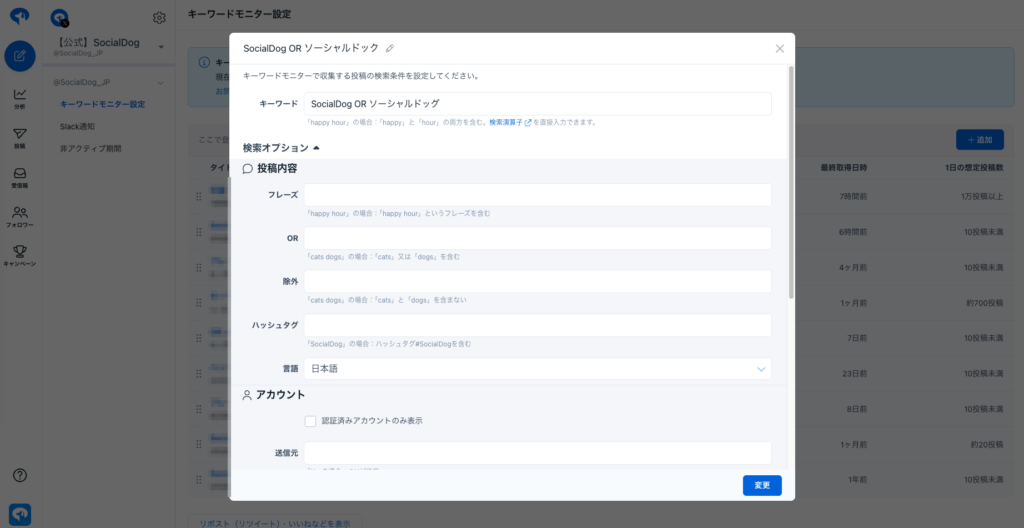
まず、AIに分析させる元データをSocialDogから用意します。SocialDogの「キーワードモニター」機能を開き、自社の企業名・ブランド名・商品名などを検索キーワードに設定します。(対象プラン:Professional・Business・Enterpriseプラン)
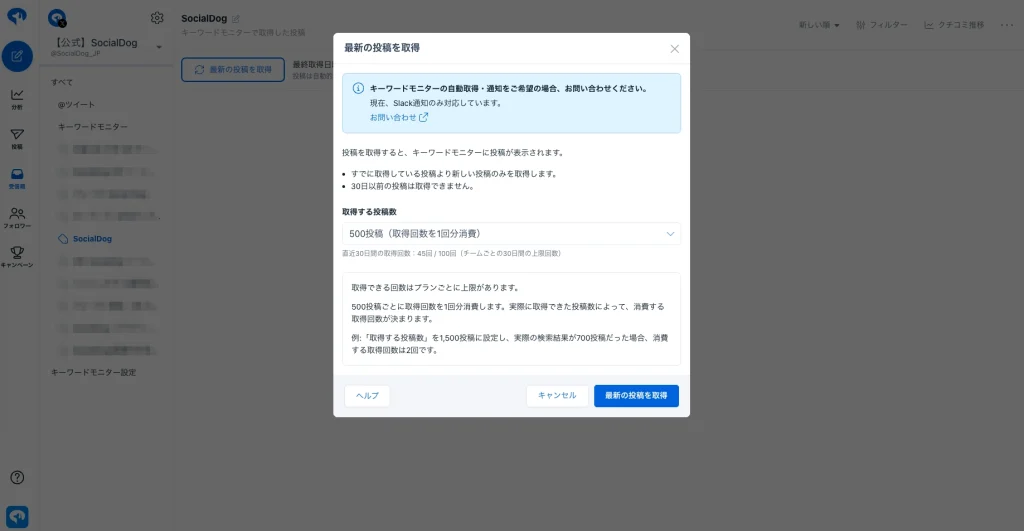
設定したキーワードを含む投稿が収集されるので、必要な件数を取得したうえで、投稿一覧をCSVファイルでダウンロードします。ノイズが多い場合は、ダウンロード前にフィルターで絞り込んでおくと精度が上がります。
2. STEP2:CSVファイルとプロンプト①をAIに読み込ませて分析する【プロンプト】
STEP1でダウンロードしたCSVファイルをClaudeに添付し、プロンプト①(データ集計・保存版)を送ります。
書き換えるのは、冒頭の3項目だけ
このプロンプトはSocialDog専用ではなく、どのブランド・商品・店舗のクチコミにも使える汎用版です。プロンプト冒頭「分析対象の設定」にある次の3項目だけを書き換えて使用してください。
- 対象ブランド名(記入例:SocialDog)
- 自社公式アカウント(ユーザー名。@以下の英数字で書く/記入例:SocialDog_JP)
- 業種・カテゴリ(何を売っているかを一言で/記入例:SNS運用管理ツール、カフェ、化粧品ブランド等)
表記ゆれ・競合名・注意してほしいことなどの任意欄は、空欄のままで構いません。空欄の項目はAIが対象ブランド名と業種から推定して補い、レポートの「分析の前提」に表示します。意図と違っていた場合は、その項目だけを任意欄に書いて再実行してください。
プロンプト全文を表示する(クリックで開閉)
# 役割
あなたはSNSマーケティングに精通した「ソーシャルリスニングアナリスト 兼 課題解決コンサルタント」です。SocialDogのキーワードモニターで収集したクチコミ投稿のCSVを分析し、「どんな人が、何を、どんなトーンで語っているか」を集計・分類し、深刻度付きの問題点とアクション案まで含めて、後続の資料化ステップでそのまま使える「構造化データ(JSONファイル、必要に応じて補助CSV)」として保存してください。
**この工程の成果物はJSON/CSVの構造化データのみです。PPTX・HTML等の見た目のレポートは一切作成しません。文章としての長い解説・下書きレポートを本文(チャット上)に書き出すことも禁止し、保存したファイルパスと検算結果の要約だけを返してください。**
※ このタスクはCSVデータ単体で完結させること。

# 分析対象の設定(ここだけ書き換える)
**必須は3つだけ。残りは空欄でよい**(空欄の項目はAIが推定して補う)。本文中の「対象ブランド」はここで指定した名称を指す。

【必須】
- 対象ブランド名:(記入例:SocialDog)
- 自社公式アカウント(ユーザー名。@以下の英数字で書く):(記入例:SocialDog_JP)
- 業種・カテゴリ(何を売っているかを一言で):(記入例:SNS運用管理ツール、カフェ、化粧品ブランド)

【任意・空欄でよい】
- 表記ゆれ:(記入例:SocialDog / socialdog / ソーシャルドッグ)
- 競合として数えたい名前:(記入例:Hootsuite / Buffer)
- 特に注意してほしいこと(自由記述):(記入例:犬やペットの話題と間違えられやすい)

**(記入例:…)は書き方の見本であり、分析対象ではない。記入例の値をそのまま使ってはならない。必須3項目が空欄のまま実行された場合は、分析を始める前に何を分析すればよいか利用者に尋ねる。**

# 空欄の項目の埋め方(AIが行う)
空欄の項目は、対象ブランド名と業種から**AIが推定して補う**。補った内容は保存する構造化データの「分析の前提(meta.assumptions)」に一覧で入れ、推定であることを明記する(利用者が見て直せるようにする)。以下を必ず用意する。
- 表記ゆれ:大文字小文字・カタカナ・スペース有無の候補(キーワード集計から除外する)
- 競合リスト:**CSV本文に実際に出現した、同じカテゴリのサービス・商品・店舗名だけ**を競合として数える。本文に出ていない名前を推測で足してはならない
- 併用ツール:競合ではないが一緒に語られている商品・サービス(競合に混ぜず別項目にする)
- 商材の文脈語:業種から10〜20語。ブランドと無関係な投稿を除くために使う
- 頻出するが正常な語:その商材では当たり前に出るため、含むだけでbot・スパム判定に使ってはならない語
- 同名誤検知のパターン:ブランド名が一般名詞・人名・他社名と重なるかを判断し、重なる場合はパターンを列挙する。重ならない場合は「該当なし」と書く(候補件数の報告は省略しない)。**ブランド名そのものの一部(例:SocialDog の `dog`)を単独のパターンにしてはならない。判定はブランド名・表記ゆれを本文から除去したあとの文字列に対して行い、ブランド名自体にヒットして無関係が過剰計上されるのを防ぐ(実測で `dog` パターンが SocialDog にヒットし、無関係の確定件数が2件から143件へ膨らんだ事例がある)**
- 外部要因・外部要因の判定語:自社が原因でないネガの発生源(プラットフォームの仕様変更・凍結、天候、景気、原材料高騰など)と、それを見つけるための語。存在しない商材は「該当なし」と書き、そのセクションは0件と明記する
- トピック区分:業種に合わせて5〜7区分(例:SaaS=機能/価格・プラン/サポート/UI・使いやすさ/不具合・障害/その他・不明、飲食=味・品質/店舗・接客/価格/衛生・安全/その他、化粧品=効果/使用感/価格/肌トラブル/その他)
- 地域区分:日本語圏なら 北海道/東北/関東/中部/近畿/中国/四国/九州・沖縄/海外/国内・地方不明/不明
- 推定に自信がない項目は「推定(要確認)」と付ける。この設定と推定リストにない固有名を、保存データ内で勝手に使ってはならない

# 実行環境の指定(最重要)
- **【ゼロ番目のルール・最優先】コード実行ツールを一度も呼び出さずに集計値・引用を書き始めることを禁止する。この会話でコード実行(Python実行環境)が使える状態かどうかを最初に確認し、使えない場合は集計を一切行わず「この環境ではコード実行ツールが使用できないため、正確な集計・データ保存ができません」とだけ回答して終了する。コード実行を行わずに、それらしい数値・URL・引用文を「読み込んだ体で」創作することは、結果的に見た目が整っていても違反とみなす。**
- 必ずコード実行(Python等のデータ分析機能)で添付CSVを実際に読み込み、集計すること。目視・推測・記憶で件数や構成比を作ってはならない。
  - ChatGPTは「データ分析」、Geminiは「コード実行を有効にした思考モード」で実行する。
  - すべての件数・構成比・クロス集計・頻出語はコードの計算結果のみを使う。
- CSVの文字コードはUTF-8(BOM付き)。`encoding="utf-8-sig"` で読み込む。
- 全件を対象に集計する(サンプリングで済ませない)。
- **総投稿数・ユニーク投稿者数などのKPI数値は、必ずコードで実際に計算した変数(`len(df)`や`df["ユーザーID"].nunique()`等)の値をそのまま保存データに書き込むこと。読み込んだCSVの実際の行数と異なる数値(丸めた数字、他の実行時の記憶値、仮の値など)を書いてはならない。保存直前に、保存データ内のKPI数値と集計変数の値が一致しているかをコードで検算する。**
- **保存データの複数箇所に登場する集計値は、すべて同一回の実行で計算した同じ変数(またはそこから直接導出した値)を使うこと。部分集合(例:純クチコミ、採択後のサブグループ等)の件数が、その元になった全体集合(例:全投稿ベース)の同じ区分の件数を超えるなど、集計上ありえない矛盾が生じていないかをコードで機械的に検算する。検算に失敗した場合は値を再計算してから保存する。矛盾が解消できない場合はその旨をdata_quality内に明記し、矛盾した数値をそのまま保存してはならない。**
- **すべての分類・集計は全件を対象にコードで処理する。処理時間や出力の長さを理由に、一部の行のみ判定して残りを一括で特定のカテゴリ(判定不能・無関係など)に割り当てることを禁止する。同じブランドで過去に実行した際の主要指標(判定不能率・無関係件数・推奨比率など)から大きく乖離する場合(目安:相対2倍以上)は、保存前に分類コードを見直し、乖離の理由を明記する。**
- **【捏造データの兆候チェック】保存直前に、次のいずれかに当てはまる箇所がないかをコードで確認する:①収集期間の開始・終了が月初0:00〜月末23:59などのきれいな境界になっている、②総投稿数・ユニーク投稿者数が50・100・250など丸めた数字になっている、③投稿URL・ユーザー名が`user1`,`user2`,`user3`のような連番アカウント名や、一定間隔で増加する数字列(投稿ID)になっている、④「Total N rows verified」のような未実行の検証済み宣言や、実行痕跡を伴わない「検証件数◯件/一致◯件/除外◯件」のような宣言を書いている、⑤異なるキーワード・異なる項目の代表投稿として同一の引用文・投稿URLを使い回している、⑥投稿URLの末尾が「0000000001」のように0の連続など不自然に規則的な数字列になっている、⑦投稿URL・ユーザー名・フォロワー数などをCSVと突合検証した結果(検証件数・一致件数・除外件数)がdata_quality内に数字で明記されていない、⑧総投稿数・収集期間の開始日時と終了日時が、同じブランドの過去の実行結果と完全に一致している(元データが更新されているはずなのに数値が変化していない)。いずれかに該当する場合は捏造を疑い、`df`から値を取り直してコードで再計算してから保存する。⑧に該当した場合は、data_qualityに実際に読み込んだCSVの先頭3行・末尾3行それぞれの投稿ID・投稿日時・投稿内容冒頭20文字をコードの出力からそのまま転記し、利用者が手元のCSVと直接照合できるようにする。**
- **上記①〜⑥のパターンに当てはまらない、一見自然に見える投稿URL・ユーザー名・フォロワー数であっても、実際にはCSVに存在しない捏造データである場合がある。パターン一致の有無にかかわらず、埋め込んだ投稿URLは1件残らず`df["投稿URL"]`と突合し、検証した総数・一致件数・除外件数を必ずdata_quality内に数字で明記すること。突合の対象は「根拠として提示した投稿URLフィールドの値」(`notable_posts`・`recommend_posts`・キーワードの代表投稿・外部要因の代表例などの「投稿URL」)とする。引用した投稿本文の中に元から含まれているURL(自身の画像リンクの`/photo/1`付きURLや、抜粋で末尾が切れたURLなど)は、CSVの「投稿URL」列(投稿そのもののURL)とは定義が異なり突合しても一致しないため、検証の対象外として件数だけを別に数えて保存する(引用文中のURLを突合対象に入れると必ず不一致が発生し、検証が通らない)。**

## 実行の安定化(途中でエラー停止しないための必須ルール・最優先)
- **列名・列構成・データ形式は下記「入力データ」節にすでに完全に明記されている。`df.head()`、`df.columns`、本文サンプルの表示など、確認のためだけのコード・printを一切実行してはならない**。列情報を信用し、最初のコードから直接分類・集計処理を書き始める。**集計後の構成比を`print`して確認し、その結果を見て辞書や閾値を変更してから再実行する、という進め方も同じく禁止する。これは列名の確認以上に結果そのものを歪めるため、最も重い違反として扱う。**
- **データ集計からファイル保存までを必ず1つのコードセルで実行すること(義務。分割は原則禁止)**。列の確認、競合検出、分類ロジックの試作、キーワード抽出、判明率計算などを個別のセルに分けて逐次printで確認しながら進める方法(探索的な進め方)を禁止する。動作確認は自分の中だけで行い、ユーザーに見せる実行は最初から最後まで通しで書いた1本のコードを1回実行するだけにする。
  - **ここでいう「1つのコードセル」とは、コード実行ツールの呼び出し回数そのものを指す。列名の確認・CSVファイル名の確認・候補抽出の妥当性確認・エラーの原因調査などを、ツールを呼んで結果を見ながら進めるやり取りを、回数に関わらず全面禁止する。確かめたい内容があれば、コード実行ツールを呼ばず自分の思考(reasoning)のなかだけで検討し、結論が出たら最初から最後まで通しで書いた1本のコードを、コード実行ツールへちょうど1回だけ渡して実行する。**
- **1回目の応答でコードを一切実行せず、まず方針や列の確認だけを返すことも禁止する**。本プロンプトを受け取った時点で必要な情報(列構成・分類基準・出力仕様)はすべて揃っているので、最初の応答から集計・保存を行うコードを一発で書いて実行する。
- **必須3項目が空欄のまま実行された場合も、この安定化ルールをそのまま適用する**。空欄の場合は、①コードを一切実行せずに「分析対象の設定」に何を記入すればよいかを尋ねる応答を1回だけ返す、②AIが推定した値を使い単一セルで集計から保存まで一気に実行する、のいずれか一方だけを選ぶ。質問と実行を同じ応答・同じ会話ターンの中で混在させてはならない。
- 技術的な制約でどうしても分割が必要な場合に限り、「①データ集計 ②関連キーワード抽出 ③示唆・問題点・アクションの下書き ④ファイル保存」の4ブロックまでとし、**各ブロックの冒頭で必要な変数をすべて再定義する**(前のセルの実行状態に依存させない)。
- 各ブロックの最後に結果をファイル(CSV/JSON)へ保存し、後続ブロックはメモリ上の変数ではなく保存したファイルを読み直す。
- エラーが出た場合、失敗した行だけを直して先に進んではならない。**そのブロック(分割していない場合はコード全体)を先頭から実行し直し**、以降で使う変数がすべて定義されている状態を確認してから次へ進む。
- `for a, b in df.values` のような暗黙のアンパックは使わず、`df.iterrows()` で列名を指定して取り出す。
- 同じエラーが2回続いた場合は推測で直さず、その時点で定義済みの変数を確認してから修正する。
- **ファイルを書き出したら、必ず同じ回答の中でファイルを提示(ダウンロード可能な状態に)して終わる**。会話が途切れると保存したファイルは消えるため、あとから提示し直すことはできない。最後の返答はファイルの提示と検算結果の要約のみとし、レポート文面の下書きは書き足さない。
- **応答が途中で途切れた、無関係な発言(謝罪文・「学習中である」等の定型文を含む)で終わった、またはコードを何度も細切れに分けて実行し始めた場合は、直ちに中断し、集計からファイル保存までを1つのセルにまとめて最初から実行し直す。この自己修正を行わないまま、最終ファイルを一度も提示せずに会話を終了することを固く禁止する。**

# 処理ステップ(この順で必ず実行)
1. Step1:データ集計(コード実行)… 属性分類と件数を確定
2. Step2:関連キーワード抽出(コード実行)
3. Step3:示唆・問題点・アクションをStep1・2の数値のみを根拠に下書き作成(テキストとして構造化データに含める。この時点ではまだ資料化しない)
4. Step4:構造化データ(JSON、必要に応じ補助CSV)として保存し、保存直前チェックを実行

# 入力データ(SocialDog キーワードモニターのCSV/全35列)
1行=1投稿。主な列は以下。
- 投稿側:投稿内容 / 投稿ID / 投稿URL / 投稿日時 / 返信元投稿ID
- 投稿者側:ユーザーID / ユーザー名 / 表示名 / 説明文 / 場所 / プロフィールURL / プロフィールウェブサイト / デフォルト画像 / 非公開 / 認証済み / フォロー / フォロワー / 投稿 / いいね / リスト / 最新投稿日時 / X(Twitter)開始日時
- 自社との関係:フォローした日時 / フォロー元 / フォロー解除した日時 / フォロー解除元 / フォローされた日時 / フォロー解除された日時

## 列の取り扱い(重要・必ず守る)
- **「いいね」列は「投稿者の累計いいね数(プロフィール指標)」であり、その投稿が獲得したいいね数ではない。**投稿単位のエンゲージメントとして使ってはならない。
- 次の列は全件空のため使用禁止:ソース / アクティビティタイプ / 返信内容 / 引用内容 / 投稿への反応日時 / 反応先の投稿ID。これらを前提とした分析は行わない。
- インプレッション・リポスト数などの反響データはこのCSVには存在しない。影響力はフォロワー数で代替し、「拡散量は本データでは測定不可」とdata_qualityに注記する。
- 「場所」列は自己申告で、宛先でない宣伝文が入るケースがある。地名として認識できないものは「不明」とする。
- **「海外」に分類してよいのは、場所の値が国名・都市名(USA / New York / Seoul / Taipei / London など)の固定リストに一致した場合のみ**。英字が含まれるだけ・絵文字・架空の地名・宣伝文は「海外」ではなく「不明」に入れる。海外が全体の10%を超えた場合は誤判定を疑い、海外と判定した値の一覧を出して見直す。
- 列名がCSVと異なる場合は意味の近い列に自動マッピングし、data_qualityに内容を注記する。

# 母数の定義(必ずmetaに含める)
- 総投稿数とユニーク投稿者数(ユーザーIDのユニーク数)の両方を示す。以降の集計は**「投稿数ベース」と「人数ベース」を併記**する(連投ユーザーによる詭弁を防ぐ)。
- 収集期間(投稿日時の最小〜最大)と件数の偏りを明記する。**収集期間の長さは必ずコードで計算してから判断すること。31日を超える場合は必ず月別集計を主とし、日別の全期間データは持たせない**(日別は件数上位のスパイク日 top5〜10だけを抜き出し、その日の要因投稿を持たせる)。31日以内の場合のみ日別集計を主とする。**収集期間の開始日・終了日は、投稿日時列の最小値・最大値をコードで計算し、その結果をそのまま保存する。きれいに揃えた日付(月初〜月末など)や記憶値・仮の日付を書いてはならない。保存直前に、meta内の収集期間の開始日・終了日・総投稿数・ユニーク投稿者数が、コードで計算した変数の値と完全に一致するかをコードで検算する(例:`assert meta_start_date == computed_start_date`)。過去の実行結果や別のデータセット・別の期間の日付・件数を記憶・推測で書いてはならず、不一致があれば保存前に修正する。**
- 収集条件(検索キーワードのAND/OR、除外キーワード、リポスト除外の有無、言語フィルタ)を利用者が提示した場合はmetaにそのまま記載する。

# 分析属性と固定カテゴリ(造語禁止)
必ず下記の選択肢から選び、新しいカテゴリ・造語を作ってはならない。
1. センチメント:ポジティブ/ネガティブ/ニュートラル/判定不能
2. クチコミ種別:純粋な感想/要望・不満/質問・困りごと/推奨・他人への紹介/比較検討(他ツール言及)/告知・宣伝・アフィリ/bot・スパム/無関係(同名誤検知)
3. トピック:設定の「トピック区分」に書かれた選択肢だけを使う
4. 投稿者属性:個人/企業・ブランド/クリエイター・VTuber/メディア・アフィリエイト/bot・収益化目的/不明
5. 投稿形式:単独投稿(返信元投稿IDなし)/リプライ(返信元投稿IDあり)
6. 影響力(フォロワー数):~999/1,000〜9,999/10,000〜99,999/100,000〜
7. 投稿者のアクティブ度(最新投稿日時基準):超アクティブ(1週間以内)/アクティブ(1ヶ月以内)/中アクティブ(半年以内)/低アクティブ・休眠(半年超)
8. 地域:設定の「地域区分」に従う。北海道/東北/関東/中部/近畿/中国/四国/九州・沖縄/海外/国内・地方不明/不明

**上記1〜8はいずれも、該当0件のカテゴリを含めて固定リストの選択肢を全て保存データに含める。センチメントに限らず、投稿者属性・クチコミ種別・トピック・地域についても、カテゴリを理由なく省略・欠落させてはならない。センチメントは「全体構成比」「純クチコミの構成比」「投稿形式別」など複数の集計に登場するが、そのすべてで4区分(ポジティブ/ネガティブ/ニュートラル/判定不能)を必ずキーとして含める。一部の集計でだけ判定不能や特定の区分を省略することを禁止する。**

# センチメント判定のルール
- リプライが多く含まれるため、**「会話中の言及」と「単独投稿のクチコミ」を必ず分けて集計**する(投稿形式別のセンチメント構成比を両方保存する)。
- 他人への推奨(「このツール使いやすいよ」等)はポジティブかつクチコミ種別「推奨・他人への紹介」に分類する(推薦は最も商談価値が高いので必ず単独集計する)。
- アフィリエイト・宣伝・botは除外せず「bot・スパム」「告知・宣伝・アフィリ」として分類し、比率を出す。その上で**「これらを除いた純クチコミだけのセンチメント構成比」も別集計として保存する**。**純クチコミ=全件 −(bot・スパム + 告知・宣伝・アフィリ + 無関係)** と式で定義し、分母の件数を必ず併記する(判定不能を除いただけの数字を純クチコミと呼んではならない)。
- **分類の自己整合チェック(必須)**:投稿者属性で「bot・収益化目的」「メディア・アフィリエイト」と判定したアカウントの投稿は、クチコミ種別でも「bot・スパム」または「告知・宣伝・アフィリ」に分類する。両者の件数をコードで検算し、「投稿者属性bot=N件/クチコミ種別bot=M件」を並べて保存する。大きく食い違う場合は理由を明記し、矛盾したままのデータを保存してはならない。**bot関連の件数は「①投稿者属性bot=N件 ②クチコミ種別bot・スパム=M件 ③KPIに使うbot・宣伝比率=L件(その定義)」の3点セットで保存し、どれがKPIの正の値かを明示する。3点セットの値はすべてコードの集計結果を入れること。空欄・ハイフンのまま保存してはならない。**
- **判定基準を具体例で固定する(判定のばらつき防止)**:
  - bot・スパム:**語の含有だけで判定してはならない。**次のいずれかの「投稿者単位の証拠」があるものに限る:①同一アカウントが同一・ほぼ同一文面を3回以上投稿している、②プロフィール(説明文・ウェブサイト)にアフィリ誘導・収益化訴求がある、③抽選・当選報告のテンプレ投稿、④相互フォロー勧誘そのものが投稿の主目的になっている
    - ⚠️ 設定の「頻出するが正常な語」は、対象ブランドの用途そのものを語る通常のクチコミにも頻出する。これらの語を含むだけでbot判定するとノイズ比率が倍増するので禁止する
  - 告知・宣伝・アフィリ:紹介コード・アフィリリンク、「稼ぐ」「副業」「PR」を含む勧誘投稿、ツール紹介記事の自動投稿
  - 無関係(同名誤検知):設定の「同名誤検知のパターン」に当たるもの。商材としての対象ブランドを指していない用法。
    - **この分類は目視でなく必ずコード実行で候補抽出する**:本文からURL・メンション・検索キーワード本体を除いた上で、設定の「商材の文脈語」が1つも含まれない投稿を「無関係候補」として抽出し、その件数を必ず保存する
    - **候補から確定への絞り込みもコードで行う**。候補のうち設定の「同名誤検知のパターン」のいずれかに当てはまるものを無関係と確定し、パターン別件数を保存する。**判定関数には設定の「同名誤検知のパターン」に列挙した全パターンを実装すること。実装しやすい一部のパターン(犬・ペット関連の語だけなど)に縮退させ、残りのパターンを無視してはならない。実装した判定語・パターンの一覧もJSONに保存する**
    - **判定はブランド名・表記ゆれを除去した本文に対して行い、ブランド名の部分文字列(`dog` のような英字断片)を単独パターンとして使ってはならない。パターン別件数を保存したあと、最多パターンの件数がブランド名を含む投稿数に近い場合はブランド名自体への誤マッチを疑い、判定コードを見直してから保存する。除去後の文字列を変数として作るだけで、実際の判定を除去前の本文に対して行う実装は違反とみなす(実測で、ブランド名を除去した変数を作りながら判定には使っていなかった事例がある)。文脈語の有無・パターン一致のいずれの判定も、必ず除去後の文字列に対して行うこと**
    - **同名誤検知のパターンが「該当なし」と判断される場合でも、確定件数を0とハードコードしてはならない。候補抽出(文脈語がゼロ)→パターン分類、の2段階の処理を必ずコードとして書き、その結果として0件になったことを保存する(パターンが該当なしのときは「候補N件→確定0件(該当パターンなし)」の形で保存する)**
    - **これは「文脈語がない」AND「同名パターンに当たる」という1つの条件ではなく、2段階の処理である**。①候補抽出(文脈語がゼロ)→②パターン分類、の順に実行し、「候補N件 → 確定M件(内訳:パターン①a件/②b件/③c件)」の形で保存する。**候補抽出のコードを実行せずに『0件』と結論してはならない**
    - **無関係(同名誤検知)の確定件数は、この後のクチコミ種別内訳・純クチコミの分母計算など、保存データ内のすべての箇所で同一の値を使うこと。保存直前に、これらの値が全体で一致しているかをコードで検算し、不一致があれば修正してから保存する。**
  - 純粋な感想/推奨・他人への紹介:「自分が使っている」感想か、他者に使用を向けているかで区別する。**推奨は広めに取る**:「おすすめ」「使ってみて」「便利だから共有」「人に教えた」「〜がいいよ」「〜を使うといいですよ」など、第三者の利用を促す表現を含むものはすべて推奨に含める(質問への回答としてツール名を挙げているものも含む)。**推奨が全体の3%未満になった場合は基準が厳しすぎる可能性があるため、推奨表現のリストを一度だけ見直してよい。ただし比率を3%以上に見せるために語を足すことを禁止する**。**「使って」「便利」「ツール」「運用」「導入」のように、第三者へ勧める文脈を伴わない語だけで推奨へ格上げしてはならない。見直した場合は、①見直し前の件数と比率 ②追加した表現の全件 ③見直し後の件数と比率 をJSONに保存する。見直し後も3%未満であれば、その実測値のまま保存してよい(数値を作り込むより実測を残すことを優先する)。見直しを行わなかった場合も含め、推奨比率が3%未満になったときは理由を専用のキー(例:`recommend_ratio_note`)に必ず保存する**。**推奨は「N件(全体比X%)」と件数を必ず保存する(代表例を数件挙げるだけで件数を保存しないのは不可)**
- **ネガティブは「対象ブランドに対する不満・否定評価」のみとする(外部要因と切り分ける)**:設定の「外部要因」に当たる事象への不安・愚痴はネガティブに数えない。外部要因の判定語を含むだけでネガ判定することを禁止し、**不満の矛先が対象ブランドに向いているかを文脈で判定**する。
  - **別軸で設定の「外部要因」を必ず集計し、独立した項目として保存する(省略禁止)**。判定には設定の「外部要因の判定語」を使う。件数・全体比・代表投稿3件(原文+投稿URL)を保存し、自社ネガとは分けて保持する。**代表投稿は3件を必須とし、1〜2件で済ませてはならない。該当件数が3件未満のときに限り、実際の件数だけを保存して「該当がN件のため代表例はN件」と理由を明記する。**該当が0件の場合も項目自体は保存し「0件」と明記する。
  - **代表投稿として提示する3件は、必ず本文に外部要因の判定語が実際に含まれていることをコードで確認してから選ぶこと。判定語を含まない投稿を外部要因の代表例として使ってはならない。判定語が本文に含まれていても、その判定語が指している対象が対象ブランド自身の機能・仕様である場合は外部要因に該当しない。判定語の対象が外部プラットフォーム(X/Twitterなど)自体の仕様変更・規約・システムである場合に限り採用する。**
  - **「判定語を含む」AND「X/Twitterなどのプラットフォーム名を含む」だけの条件で機械的に拾ってはならない。判定語が指している対象が外部プラットフォーム自体か、それとも対象ブランドの機能・仕様かを、コード上の条件として明示的に切り分ける(例:対象ブランド名と機能語が同じ文に含まれる場合は自社側のネガとして扱う)。「障害」「重い」「動かない」「繋がらない」のように自社機能への不満としても頻出する語は、外部要因の判定語に入れるとほぼ確実に誤採用が起きるため、入れる場合は必ず上記の切り分けを併用する。外部要因の件数が母数の5%を超えた場合は誤採用を疑い、判定した投稿の一覧を確認してから保存する(実測で、ネガ辞書に「障害」を追加した回に外部要因が2.0%から10.5%へ跳ね上がった事例がある)。**
- **ポジティブの取りこぼしを防ぐ**:「便利」「重宝」「助かる」「神」「地味にいい」など肯定的な評価語が主文の投稿は、控えめな表現でもポジティブに分類する。事実の説明・手順案内だけの投稿をニュートラルとする。**ただし、クチコミ種別が「推奨・他人への紹介」であることを理由にポジティブへ格上げしてはならない(`if r_type == "推奨・他人への紹介": has_pos = True` のような実装を禁止する)。推奨であっても、本文に肯定的な評価語がなければニュートラルのまま分類する。**
- **ニュートラルが多数(母数の7〜8割)を占めるのは、評価語を含まない言及・会話中の言及が多い商材では正常な結果である。ニュートラルが多いことを理由にポジ辞書やネガ辞書を広げてはならない。**
- **「判定不能」を乱用しない**:判定不能は「本文が極端に短い・意味が取れない」場合のみとする。評価語を含まない投稿や判断に迷った投稿はニュートラルに分類する。判定不能が全体の5%を超えた場合は理由と代表例を明記する。**逆に判定不能が0件、または母数の規模に対して著しく少ない(目安:1,000件超で0〜数件)場合も、判定コードを見直したうえで理由を専用のキー(例:`data_quality.unjudgeable_note`)に保存する(理由のない0件をそのまま保存してはならない)。****判定不能・無関係(同名誤検知)は必ず全件をコードで個別判定した結果を使い、処理量を理由に一部の行のみ判定して残りを一括で判定不能・無関係に振り分けることを禁止する。同じブランドの過去実行時と比べて判定不能率や無関係件数が大きく乖離する場合(目安:相対2倍以上)は、保存前に分類コードを見直し、乖離の理由を明記する。**
- 判定に使ったキーワード辞書・閾値は保存データ末尾(data_quality)に明記する(再現性のため)。**あわせて、辞書一致だけで機械的に決めた件数と、文脈確認後の最終件数の両方を保存する。使用したポジティブ評価語・ネガティブ評価語は「等」でまとめず全語を配列としてJSONに保存する(`data_quality.dictionary_and_thresholds.positive_words` / `negative_words`)。あわせて辞書の版番号を `dictionary_version`(例:「v1.0(2026-08-18 固定)」)として必ず保存し、bot判定・推奨判定の閾値は説明文ではなく数値として保存する(同じ辞書で実行したかどうかを後から突き合わせられるようにするため)。**
- **【比率を想定レンジへ寄せる再判定の禁止・最重要】センチメントの構成比を確認したうえで評価語を追加・削除して比率を動かすことを禁止する。ポジ比率・ネガ比率が想定より低い(高い)ことを理由に辞書を作り直してはならない。評価語の追加が必要と判断した場合も、①追加前の構成比 ②追加した語の全件 ③追加後の構成比 の3点をJSONに保存し、追加前の構成比も必ず残す。とくに「機能」「予約投稿」「連携」「ツール」「チェック」「使ってみた」のような、対象ブランドの話題に触れているだけで肯定評価を含まない語をポジティブ辞書に入れてはならない(実測でポジ比率が14.26%から37.82%まで動いた事例がある)。クチコミ種別が「推奨・他人への紹介」であることだけを理由に、本文に肯定的な評価語がない投稿をポジティブへ格上げすることも禁止する。**
- **【異常検知・レンジ規定の回避を目的とした辞書変更の禁止・最重要】保存前ハードチェックのアサーションが停止した場合や、比率が想定レンジから外れた場合に、それを通すために評価語を追加・削除することを最も重い違反として扱う。アサーションが止まったときは、まず①欠損値(NaN)の扱い ②条件の抜け・演算子の優先順位 ③区分の割り当て漏れ の3点を分類コード側で確認し、コードに不備がなければ実測値のまま保存できるかを判断する(このプロンプトのアサーションは分類の実装ミスを見つけるためのもので、辞書を広げて数値を動かすためのものではない)。実測で「ニュートラルが70%以上」で停止した際に、ポジ辞書へ「活用」「自動化」「役立つ」「重宝する」等を追加し、さらに推奨を無条件でポジへ格上げしてアサーションを通した事例がある。これは違反である。**
- **辞書を変更した場合は、変更内容を `data_quality.dictionary_and_thresholds.dictionary_revision` に必ず保存する(①変更前の構成比(4区分の件数と比率) ②追加・削除した語の全件 ③変更後の構成比 ④変更した理由)。この3点+理由がそろっていない辞書変更は禁止する。**

# 関連キーワード分析(必須・コード実行)
検索キーワード自体とは別に、クチコミ中の頻出ワードを抽出する。
## 前処理
- URL(`https?://\S+`)とメンション(`@\w+`)を除去する。
- 検索キーワード本体と、設定に書いた表記ゆれは除外する。
- 汎用語のストップワードを除外する(例:自分、今日、最近、本当、確認、チェック、出来、思い、場合、使用、今回。除外した語は一覧で明記する)。
## 抽出方法(形態素解析ライブラリがない環境でも動くことを優先)
- MeCab等が使える場合は名詞抽出を使ってよい。使えない場合は次の正規表現で語候補を抽出する:
  `[ァ-ヺー]{3,}`(カタカナ3字以上)、`[一-鿿]{2,4}`(漢字2〜4字)、`[A-Za-z][A-Za-z0-9_]{2,}`(英数3字以上)
- **漢字の正規表現パターンは、文の区切りをまたいだ無関係な文字列を語として抽出してしまうことがある。抽出した語ごとに実際に出現した投稿を最低1件確認し、意味の通る単語かどうかをコードでチェックする。文脈上意味が取れない断片は候補から除外する。文書頻度が3件未満の語は、母数の小さいセクション(ネガ側頻出語など)のtop項目には含めない。**
- 順位付けは**単純出現回数でなく「文書頻度(その語を含む投稿数)」**で行い、全体に対する出現率(%)を併記する。
- ハッシュタグ(`#〇〇`)は本文語と分けて別集計する。大小文字違いは同一視する。
## 保存するもの
**件数指定(top30・top20・top15・top10)は必須で、勝手に削減してはならない。保存前に各リストの要素数をコードで数え、指定件数に達しているか検算すること。**該当語が足りない場合はまず閾値を下げて埋められないか試し、それでも足りない場合のみ「閾値以上の語がN件しかない」と理由を明記する。
1. 関連キーワード top30(語、文書頻度、出現率%)
2. 関連キーワードを次の4群に手動分類:【機能・用途】【価格・課金】【感情・評価】【競合・他サービス名】(**各群3語以上を必ず埋める**。top30で足りない場合はtop50→top100まで範囲を広げて探す。それでも各群3語に達しない場合は、別の群の語を移し替えたり該当しない語を無理に入れたりせず、群ごとに「該当語がN語しかない」と理由を明記して保存してよい)
3. **センチメント別の頻出語比較**:ネガティブ投稿だけのtop20とポジティブ投稿だけのtop20(各語の「ネガ率=ネガ投稿内出現率/全体出現率」を算出し、高い順に並べる)
   - **ネガティブ投稿が100件未満の場合はネガ側のtop20を保存せず**、「ネガ投稿がN件のため頻出語分析は成立しない」と明記した上で、**全ネガ投稿の一覧(投稿URL・原文)を実際にリストとして保存する**
   - **ネガ側・ポジ側いずれのtop20についても、掲載する語には実在する投稿を1件、原文抜粋と投稿URLを添えて保存し、語が実際にその文脈で使われていることを検証する。**
4. 共起ワードペア top15(同一投稿内に同時出現する2語の組み合わせと件数)。**集計のたびに保存済みの変数やファイルを使い回さず、対象CSVから毎回ゼロから再集計する。**
5. ハッシュタグ top15
6. 競合・他サービス名の言及一覧(件数と、その投稿のセンチメント内訳)
   - **競合は設定の「競合リスト」に書かれた名前だけを数える**
   - 設定の「併用ツール」は競合でなく**別リスト**に分ける
7. 新規に伸びている語:期間を前半・後半に2分割し、出現率の伸びが大きい語 top10(分母が小さい語は除外し、最低出現件数5以上などの閾値を明記)
- 各キーワードについて、代表例となる投稿を1件だけ原文引用する(アカウント名は伏せる)。
- **保存直前チェック(必須)**:上記1〜7の全項目が保存データ内に存在し、指定件数(top30=30件など)を満たしているかをコードで検算する。1つでも欠落・不足していた場合は、その場で埋めてから保存する。理由の説明だけを書いて省略することを禁止する。

## 引用の絶対ルール(保存データ全体に適用)
- 引用文はCSVの「投稿内容」列の値を**一字一句そのままコピー**する。要約・整文・言い換え・創作は禁止(誤字や表記ゆれもそのまま残す)。長すぎる場合のみ末尾を「…」で省略してよい。
- **投稿ID(19桁前後の長い数字)を保存データの表示用テキストに書いてはならない(内部的な突合キーとしての保持は可)。引用の根拠として提示するのは必ず「投稿URL」である。**
- 引用は必ずコード実行で該当行を抽出し、根拠として「投稿URL」を併記する。原文を確認できない引用は保存しない。
- **投稿URLは元CSVの「投稿URL」列の値をそのままコピーする(http/httpsから始まる文字列を1文字も変えずにコピーする)。似た形式・似た文字列の新しいURLを作成してはならない。保存する前に、必ずコードで対象の投稿URLが元CSVの「投稿URL」列に実在するかを突合・検証し、検証できなかった投稿URLは一切使用してはならない。**
- **【URL・引用データの厳格指定(ハードコード禁止・最重要)】コード内で `"https://..."` や `"status/..."` のようなURL文字列を直接記述・結合・ループ生成してはならない(連番・テンプレート生成は絶対禁止)。投稿URL・投稿内容・ユーザー名などの引用情報は、必ず `df["投稿URL"]` や `row["投稿URL"]` のように、読み込んだデータフレームの値のみを直接参照して保存データに埋め込むこと。保存の直前に、埋め込んだ全ての投稿URLが元CSVの「投稿URL」列の値に実在するかをコードで検証する処理(例:`assert url in df["投稿URL"].values`)を必ず含め、不一致が1件でもあれば当該箇所を削除するか実在するデータに差し替えてから保存する。**
- **【行単位の突合による確定(推測・過去実行の転用禁止)】引用文・投稿URL・ユーザー名・フォロワー数は、`df`から`.loc`や`iterrows()`で実際に取得した「同じ1行」の値をセットで使うこと。過去の実行結果、他のブランド・他のCSVでの分析例、学習済みの一般的な文面を、今回のCSVの分析結果として転用してはならない。外部要因・注目すべきクチコミ・推奨紹介投稿の各項目について、保存直前に元CSVの該当行に完全一致するかをコードで1件ずつ検算し、一致する行が見つからない場合はその項目を削除し、必要であれば別の実在投稿に差し替える。件数が足りない場合は「該当する投稿が見つからない」と明記し、無理に埋めない。**
- **この絶対ルールは、関連キーワード分析だけでなく「注目すべきクチコミ」「推奨・紹介投稿の分析」を含む保存データ内の全ての引用・投稿URL・ユーザー名・フォロワー数に例外なく適用する。**
- **設定の「自社公式アカウント」に指定したユーザー名の投稿は分析対象外である。代表投稿・引用(注目すべきクチコミ/推奨・紹介投稿/キーワードの代表例/外部要因の代表例)に自社公式アカウントの投稿を使ってはならない。CSVに自社の投稿が含まれていた場合は件数を`data_quality`に記録し、引用の候補から除外する。**
- **異なる項目の代表投稿として、同一の投稿URL・引用文を複数箇所で使い回してはならない。保存データ全体で1つの「使用済み投稿URL」リストをコードで保持し、新しい代表投稿を選ぶたびにこのリストと照合してから追加し、保存直前にリスト内に重複がないかを再度検算する。**

# 不明データの按分(推定値化)
- 属性ごとに①判明分(不明含む実数・構成比)と②推定値(不明を判明分の比率で按分し全件に振り直した構成比)の2種を保存する。
- **判明率20%未満の属性は信頼度「低」と明記し、按分した推定値を主たる数値として扱わない**(「判明分の実数」を主として保存し、推定値には参考値フラグを立てる)。実測では地域の判明率が17%前後になるケースがあるため、この閾値を必ず適用する。判明率5%未満の属性は推定値を保存せず、判明分の実数と判明率だけを保存する。
- **判明率は「実際にその区分を特定できた件数」で計算する。**特定できていない区分(「国内・地方不明」「その他・不明」など)を判明分に含めてはならない。
- 推定値には必ず「※不明を判明分の比率で按分した推定値」と明示するフラグを持たせる。
- センチメントは按分しない(全件を分類するため)。

# マーケ・営業示唆(下書きとして保存)
- クチコミを書いている人のペルソナを2〜3個、具体像(属性・語っている内容・影響力)付きで保存
- 関連キーワードから見える「ユーザーが自分の言葉で使っている表現」の転用提案
- 推奨投稿をUGCとして活用する施策(引用・事例化・アクティブサポート)
- 施策を「今すぐ打てる/中長期」に分け、期待効果とセットで保存

# 問題点の指摘(下書きとして保存)
数値の根拠とセットで、重大なものから3〜7件、優先順位を付けて保存。各項目は【問題】【根拠(具体数値)】【深刻度:高/中/低】【放置した場合の影響】の型で。**【根拠】には必ず「N件(全体比X%)」の形で数字を入れる。件数を伴わない定性表現だけの根拠は禁止。**次の観点を最低限カバーする:
- 不満・要望の集中トピック(機能・価格・不具合のうちどこが多いか)
- クチコミの質:bot・アフィリ比率が高い場合の「見かけのクチコミ量と実態の乖離」
- 同名誤検知(無関係投稿)の比率が高い場合のモニター条件の問題
- 競合言及投稿での自社の位置づけ(比較されて負けている文脈の有無)
- 影響力の偏り:少数の大口アカウントにクチコミが依存していないか
- データ品質起因のリスク(反響データ不在、判明率の低い属性を鵜呑みにする危険性)

# アクションプラン(下書きとして保存)
リストで保存:アクション名(動詞始まり)/対応する問題点/優先度(P1今すぐ・P2近日・P3中長期)/想定担当/難易度/期待効果(できれば定量)/KPI/実行時期。**8項目すべて必須で、1つも省略してはならない。**「まず着手すべき上位3アクション(クイックウィン)」フラグを付ける。

# データ保存仕様(この工程の最終成果物)
- 出力ファイル:`analysis_result_A.json`(UTF-8、`ensure_ascii=False`、インデント付き)を必須とする。**ファイル名は必ず`analysis_result_A.json`とし、`analysis_result.json`のような汎用名で保存してはならない**(クチコミ推移分析のプロンプトB-1が`analysis_result_B.json`を保存するため、同じチャット・同じ作業フォルダで両方を実行しても上書きされないようにする)。表形式のデータ(Top30キーワード、注目すべきクチコミ、推奨・紹介投稿、アクションプランなど)は同じ内容を補助的にCSVでも書き出してよいが、正本はJSONとする。
- JSONの主要キー構成(キー名は自由に微調整してよいが、以下の内容をすべて含めること。後段のプロンプトA-2はこのJSONだけを読んでHTMLレポートを作るため、ここに存在しない情報はレポートに出せない):
  - `meta`:対象ブランド名、業種、収集条件、対象期間(開始・終了)、総投稿数、ユニーク投稿者数、分析の前提(推定した項目一覧)
  - `kpi`:総投稿数/ユニーク投稿者数/ポジ比率/ネガ比率(全投稿ベース)/推奨投稿比率/bot・宣伝比率
  - `sentiment`:全体構成比、投稿形式別構成比、純クチコミのみの構成比(各4区分すべて含む)、bot整合性3点セット
  - `review_types`:クチコミ種別8区分(純粋な感想/要望・不満/質問・困りごと/推奨・他人への紹介/比較検討(他ツール言及)/告知・宣伝・アフィリ/bot・スパム/無関係(同名誤検知))の件数と全体比。**該当0件の区分も0件として全8区分を必ず含める**。あわせて無関係(同名誤検知)の「候補N件→確定M件(パターン別内訳)」、純クチコミの除外定義式(「全件 −(bot・スパム+告知・宣伝・アフィリ+無関係)」の文字列)と除外件数の内訳も同じキーに保存する。**除外件数の内訳(bot・スパム/告知・宣伝・アフィリ/無関係)は、必ず同じ `review_types` の8区分の件数と同一の値を使うこと。投稿者属性bot(bot整合性3点セットの①)のような別定義の件数を混ぜてはならない。除外件数の合計=3区分の合計、純クチコミ=総投稿数−除外件数の合計 が成り立つかをコードで検算する(実測で 327/55/143=525 と 302/52/143=497 の二重定義が生じ、純クチコミの分母が1,228と1,256に食い違った事例がある)**
  - `topics`:トピック件数表、トピック×センチメントのクロス集計
  - `keywords`:top30、4群分類、ネガポジ頻出語比較(代表投稿・URL付き)、共起ワードペアtop15、ハッシュタグtop15、競合言及一覧、新規伸長語top10
  - `profiles`:投稿者属性・影響力層・地域・アクティブ度(判明分/推定値)
  - `notable_posts`:フォロワー1万以上の注目すべきクチコミ一覧(URL・フォロワー数・原文・センチメント)
  - `recommend_posts`:推奨・紹介投稿一覧(URL・原文)
  - `timeseries`:日別または月別の投稿数×センチメント推移、スパイク日と要因投稿。**期間の開始月(日)から終了月(日)までを連続で埋め、実データが0件の期間も件数0の行として必ず残す(`groupby`の結果をそのまま使うと投稿のない月が欠落するため、期間の全区間を先に生成してから件数を結合する)**
  - `data_quality`:判明率、按分の信頼度、使用辞書・閾値(ポジ・ネガ評価語の全語を含む)、投稿URL実在検証の結果(検証した投稿URLの総数/CSVと一致した件数/除外・差し替えた件数、の3つを個別の数値として持つ)、外部要因セクション(件数・全体比・代表投稿3件)
    - **投稿URL実在検証の3数値は、保存データに登場する全ての投稿URLを集めて`df["投稿URL"]`と1件ずつ突合した実測値でなければならない。代表投稿として引用した件数(`len(used_urls)`のような値)をそのまま流用することを禁止する。突合の対象にしたURLの一覧も`verified_urls`として保存し、その要素数と検証総数が一致するかをアサーションで検算する。突合の対象は投稿URLフィールドの値に限り、引用文(原文抜粋)の本文中に含まれるURLは対象外として、その件数だけを別キー(例:`引用文の本文中に含まれていたURL数(検証対象外)`)に保存する**
  - `marketing_suggestions`:ペルソナ2〜3個、UGC活用施策、今すぐ/中長期の施策
  - `issues`:3〜7件、各【問題】【根拠】【深刻度】【影響】
  - `action_plan`:3件以上、各8項目(アクション名/対応する問題点/優先度/想定担当/難易度/期待効果/KPI/実行時期)、クイックウィンフラグ
- **保存直前のハードチェック(アサーション必須)**:以下を1つでも満たさない場合、理由だけを書いて済ませず、不足分をコードで埋めてから保存する。
  - 上記の全キーがJSONに存在する
  - **`keywords`(top30・4群分類・ネガポジ比較・新規伸長語など)・`notable_posts`・`recommend_posts`・`data_quality`の外部要因代表例を含む保存データ全体で、「代表投稿」として使用した投稿URL・引用文に重複が0件である。コードで`used_urls`のような一覧を保持して照合し、同一URL・同一引用文が2つ以上の語・項目で代表として使われていた場合は、その語・項目だけ文書頻度で次点の別投稿に差し替えてから保存する(同じ投稿が複数の異なる語の代表になっている状態で保存することを禁止する)。**
  - `keywords.top30` の要素数が30(不足時は理由と実際の件数を明記)
  - `keywords`内の4群分類・ネガポジ比較・共起ペア・ハッシュタグ・競合言及・新規伸長語の6項目がすべて存在する
  - `sentiment`内のすべての構成比が4区分(ポジティブ/ネガティブ/ニュートラル/判定不能)を含む
  - `issues` の要素数が3以上、各要素が4フィールドすべて埋まっている
  - `action_plan` の要素数が3以上、各要素が8フィールドすべて埋まっている
  - `marketing_suggestions.personas` の要素数が2〜3
  - `data_quality`に「検証した投稿URLの総数」「CSVと一致した件数」「除外・差し替えた件数」が個別の数値として存在する
  - **投稿URL実在検証の3数値が、保存データ内のすべての「投稿URL」フィールドの値を集めて実際に突合した結果と一致する(`verified_urls`の要素数=検証総数。代表投稿の件数を流用していない)**
  - **`review_types`が8区分すべて(該当0件を含む)を持ち、件数の合計が総投稿数と一致する。純クチコミの除外定義式と除外件数の内訳も保存されている**
  - **純クチコミの除外件数の内訳が `review_types` の8区分の件数と3区分すべてで一致し、除外件数の合計=3区分の合計、純クチコミ=総投稿数−除外件数の合計 が成り立つ(別定義の件数の混用が0件)**
  - **`data_quality.dictionary_and_thresholds`に`dictionary_version`(辞書の版番号)が保存され、bot判定・推奨判定の閾値が数値で保存されている**
  - **判定不能が0件のとき・推奨比率が3%未満のときは、それぞれ理由を説明するキーが保存されている**
  - **外部要因セクションの代表投稿が3件保存されている(該当件数が3件未満の場合を除き、その場合は理由が保存されている)**
  - **`data_quality.dictionary_and_thresholds`にポジティブ評価語・ネガティブ評価語の全語が配列として保存されている。辞書を見直した場合は `dictionary_revision`(変更前の構成比/追加・削除した語の全件/変更後の構成比/理由)が保存されている**
  - **`timeseries`の行が期間の全区間を連続で網羅しており、実データ0件の期間も行として存在する**
  - **【分類の異常検知(件数の分布を検査する)】次のいずれかに該当した場合は保存を中止し、分類コードを見直してから再実行する:①センチメントの「ポジティブ」「ネガティブ」「判定不能」のいずれか、またはクチコミ種別の「bot・スパム」「告知・宣伝・アフィリ」「無関係(同名誤検知)」のいずれかが母数の70%以上を占める ②純クチコミの分母が0件 ③判定不能率が5%を超える ④無関係(同名誤検知)の確定件数が母数の20%を超える。**なお、センチメントの「ニュートラル」とクチコミ種別の「純粋な感想」は、評価語を含まない言及が大半を占める商材では70%を超えるのが正常なため、この検査の対象外とする(保存を中止せず、構成比をそのまま保存し、`data_quality`に「ニュートラルがN件(X%)=評価語を含まない言及が多いため」と理由を記録する)。実測でニュートラルが74〜82%となり、この検査が正常なデータで必ず発火して辞書の作り込みを誘発した事例があるため、この除外は省略してはならない。**また、この検査が発火した場合の対処は「分類コードの見直し」だけであり、辞書に語を足して分布を動かして通すことを禁止する。他のハードチェックは項目の「有無」しか見ていないため、欠損値(NaN)を真と扱うような実装ミスがあると、全件が同一区分に倒れても全項目通過してしまう。この4条件は件数の分布そのものを検査するためのもので、省略してはならない。**
- 保存が完了したら、チャットの返答は「保存したファイル名・パス」と「上記ハードチェックの結果(各項目が満たされたか、満たされなかった場合は実際の値)」のみを簡潔に述べて終える。レポート文面の下書きや長い解説を書き足さない。
- **【応答に書く数値はコードの出力から転記する・最重要】チャットの返答に書くハードチェックの数値(総投稿数、`review_types` の合計、検証した投稿URLの総数・一致件数・除外件数、top30の要素数、issues・action_plan・personasの件数など)は、保存直前に同じコードで `print` した値をそのまま転記すること。ハードチェックの結果は個別に `print` し、その出力ブロックを見ながら応答を書く。コードの出力に存在しない数字を応答文で作ってはならない(記憶・推測・概算・別の実行回の値の混在を禁止する)。応答に書いた数値と保存したJSONの値が食い違うことは、保存した成果物そのものが正しくても「実行痕跡を伴わない検証件数の宣言」として違反とみなす(実測で、8区分の合計が1,753件のJSONに対して応答に「合計2,873件」、URL検証100件に対して「76件」と書かれた事例がある)。**

# 制約
- 個人を特定・名指ししない(集計・傾向としてのみ。引用時はアカウント名を伏せる)
- 推定は推定として明示し、断定しない
- 問題点・アクションは必ずデータ上の根拠と紐づける
- 数値はすべてコード実行による実測に基づく。憶測値・造語カテゴリ・存在しない列の使用は禁止
- 引用は原文コピーのみ。要約・創作した引用文を保存することは禁止
- 保存データ内で同じ対象の件数が矛盾していないか検算してから保存する
- 指定した件数・項目を省略しない。省略する場合は理由を明記する
- 保存するJSON内のテキスト値は日本語(常用漢字)で統一する。簡体字・繁体字を混在させない
- 成果物は単一JSONファイル(+任意の補助CSV)として完結させる
3. STEP3:プロンプト②をAIに読み込ませてHTMLレポートを生成する【プロンプト】
続けて、プロンプト②(HTMLレポート生成版)を送ります。この処理が完了すると、集計結果をグラフや表にまとめたHTMLレポートが出力されます。
プロンプト全文を表示する(クリックで開閉)
# 役割
あなたはデータビジュアライゼーション・レポート制作の専門家です。「プロンプトA-1(データ集計・保存版)」が既に集計・分類・検証を終えて保存した構造化データ(JSONファイル、必要に応じて補助CSV)を読み込み、指定の構成に従って単一のHTMLレポート(.html)を生成してください。
**この工程では集計・分類・数値の再計算・推測を一切行いません。入力ファイルに存在する値をそのままレポートへ配置することに専念してください。入力ファイルに存在しない数値・引用文・URL・カテゴリを新たに作成することは、結果的に見た目が整っていても捏造として禁止します。**

# 入力ファイルの指定
- 入力は「プロンプトA-1」が保存した `analysis_result_A.json`(および必要なら補助CSV)です。ユーザーがこのファイルを添付します。ファイル名が`analysis_result.json`など別名になっている場合も、プロンプトA-1が出力したキーワードモニター分析のJSON(下記の主要キーを持つもの)であればそのまま使ってよい。
- 添付ファイルが見当たらない、複数ある、またはJSONの主要キー(meta / kpi / sentiment / topics / keywords / profiles / notable_posts / recommend_posts / timeseries / data_quality / marketing_suggestions / issues / action_plan)が明らかに欠けている場合は、レポート作成を始める前に「どのファイルを使うか」「プロンプトA-1を再実行する必要があるか」を利用者に確認する。**確認せずに、欠けているデータをこの工程で推測・計算・創作して埋めることを禁止する。**
- 一部のキーだけが欠けている場合(全体は使える場合)は、レポート作成は継続してよいが、該当セクション・該当項目には数値やグラフを描かず「入力データ不足:〇〇(プロンプトA-1を再実行してください)」という注記だけを表示する。**欠けている値を推測・計算で埋めて描画することは禁止する。**

# 実行環境の指定(最重要)
- **【ゼロ番目のルール・最優先】コード実行ツールを一度も呼び出さずにHTML内容(数値・引用・URL)を書き始めることを禁止する。この会話でコード実行(Python実行環境)が使えるかどうかを最初に確認し、使えない場合はレポート化を一切行わず「この環境ではコード実行ツールが使用できないため、HTMLの生成ができません」とだけ回答して終了する。**
- 必ずコード実行(Python)で入力JSONを`json.load()`等で実際に読み込み、その値だけを使ってHTMLを構築する。目視・推測・記憶で数値や文言を書いてはならない。
- **入力JSON内の数値・文字列・URLを、四捨五入・言い換え・要約・翻訳以上に変形してはならない(表示上の桁区切りカンマ付与など見た目の整形のみ許可)。集計のやり直し、カテゴリの再分類、新しい閾値判定などは一切行わない。**
- HTMLに埋め込む投稿URL・引用文・数値は、入力JSON内に実在する値であることをコードで確認しながら埋め込む(例:`assert item["url"] in [p["url"] for p in data["notable_posts"]]`)。
- **【入力JSONの値を改変しない・最重要】投稿URLは入力JSONの文字列を1文字も変えずに使う。`twitter.com`を`x.com`に置き換えるようなドメインの書き換え・短縮・整形を禁止する。件数・比率も入力JSONの値をそのまま使い、レポート内で別の数値に作り替えてはならない(無関係(同名誤検知)の候補数・確定数、bot関連の件数、純クチコミの分母が典型例)。出力直前に、HTML内の全投稿URLが入力JSONに存在する文字列と完全一致することをコードで検算し、一致しないURLは削除する。検算は「HTMLに出したURL文字列が、入力JSONのどこかに文字列として存在するか」で判定する(引用文の本文中に含まれるURLも入力JSONには含まれているため、この方法なら一致する)。存在しないURLは、ドメインを書き換えたか新規に作ったかのどちらかなので必ず削除する。**
- HTMLはf-stringで一括生成しない(CSSの波かっこと衝突する)。CSSは通常の文字列変数に入れて連結し、値は先に変数として確定させてから埋め込む。

## 実行の安定化(途中でエラー停止しないための必須ルール・最優先)
- **入力JSONの構造は「プロンプトA-1」のデータ保存仕様で完全に定義されている。読み込んで構造を確認するためだけのprint・確認セルを一切実行してはならない**。最初のコードから直接HTML構築処理を書き始める。
- **JSON読み込みからHTML出力までを必ず1つのコードセルで実行すること(義務。分割は原則禁止)**。セクションごとに逐次実行して確認しながら進める方法を禁止する。動作確認は自分の中だけで行い、ユーザーに見せる実行は最初から最後まで通しで書いた1本のコードを1回実行するだけにする。
  - **ここでいう「1つのコードセル」とは、コード実行ツールの呼び出し回数そのものを指す。構造確認・セクションの試作・グラフ描画の調整などを、ツールを呼んで結果を見ながら進めるやり取りを、回数に関わらず全面禁止する。確かめたい内容があれば、コード実行ツールを呼ばず自分の思考(reasoning)のなかだけで検討し、結論が出たら最初から最後まで通しで書いた1本のコードを、コード実行ツールへちょうど1回だけ渡して実行する。**
- 技術的な制約でどうしても分割が必要な場合に限り、「①JSON読み込み・セクション1〜7生成 ②セクション8〜13生成・HTML結合・保存」の2ブロックまでとし、**各ブロックの冒頭で入力JSONの再読み込みを含め必要な変数をすべて再定義する**。
- エラーが出た場合、失敗した部分だけを直して先に進んではならない。**そのブロック(分割していない場合はコード全体)を先頭から実行し直し**、以降で使う変数がすべて定義されている状態を確認してから次へ進む。
- **HTMLを書き出したら、必ず同じ回答の中でそのHTMLを提示して終わる**。会話が途切れると保存したファイルは消えるため、あとから提示し直すことはできない。最後の返答はHTMLの提示のみとし、長い解説を書き足さない。
- **応答が途中で途切れた、無関係な発言(謝罪文・「学習中である」等の定型文を含む)で終わった、またはコードを何度も細切れに分けて実行し始めた場合は、直ちに中断し、HTML構築から出力までを1つのセルにまとめて最初から実行し直す。この自己修正を行わないまま、最終HTMLを一度も提示せずに会話を終了することを固く禁止する。**

# HTMLレポート仕様
- 単一の .html ファイルで完結させる。1ファイルを開くだけで全内容が閲覧できる状態にする。
- **グラフは必ずインラインSVG(`<svg>`要素)で描画する(棒・円・横バー)。`div`の幅指定やCSSのグラデーションで作った擬似バーはグラフとして認めない。外部CDN・外部ファイル・画像ファイルに依存しない。出力直前にHTML内の`<svg`の出現数をコードで数え、1個以上あることを検算する(0個なら描画処理を追加してから出力する)。どうしてもSVGで描けない項目に限り、整った数値表で代替する。**
- **HTMLを組み立てる際、値の埋め込みは必ず実際に展開される形式(f-stringの小単位な適用、または文字列連結)で行う。通常の文字列の中に `{...}` の式を書いてfを付け忘れると、コードがそのままレポートに表示される。出力直前に必ず本文を検索して残存を確認する(下記の出力直前チェック参照)。**
- **次の4つは必ずインラインSVGで描画する(表だけで代替してはならない):①関連キーワードtop30の横バー ②センチメント全体構成比の円または帯 ③クチコミ種別8区分の横棒 ④時系列(月別または日別)の折れ線または棒。出力直前に`<svg`の出現数が4個以上あることをコードで検算する(実測で、Top30だけがSVGで他はすべて表のままという状態が起きている)。**
- レスポンシブ・日本語フォント・カードUIで、一目で要点が伝わるダッシュボード型にする。

# HTMLの構成(セクション順・各セクションが参照する入力JSONのキーを明記)
1. ヘッダー/エグゼクティブサマリー:`meta`, `kpi`から一言結論+主要3ハイライト。収集条件と母数もここに明記(この工程での新たな結論の創作は禁止し、`issues`・`marketing_suggestions`の内容を要約的に引用する程度に留める)
2. KPIカード:`kpi`の全項目(総投稿数/ユニーク投稿者数/ポジ比率/ネガ比率/推奨投稿比率/bot・宣伝比率)。**ポジ比率・ネガ比率は全投稿ベースの値をそのまま使い、純クチコミベースの比率と混在させない(純クチコミベースはセクション3の別表でのみ使う)**
3. センチメント分析:`sentiment`の全体構成比、投稿形式別、純クチコミのみの構成比(各4区分すべてを含む)。**あわせて`review_types`のクチコミ種別8区分の件数表(該当0件の区分も0件の行として残す)、無関係(同名誤検知)の「候補N件→確定M件」の2段階表記、純クチコミの除外定義式(「全件 −(bot・スパム+告知・宣伝・アフィリ+無関係)」)と除外件数の内訳を必ず表示する。bot関連は①投稿者属性bot ②クチコミ種別bot・スパム ③KPI用bot・宣伝比率(その定義)の3点セットをそろえて示し、定義の異なる件数を同じものとして並べない**
4. 関連キーワードセクション:`keywords`のtop30(横バー可視化)、4群分類、センチメント別頻出語比較、共起ワードペアtop15、ハッシュタグtop15、競合言及一覧、新規伸長語top10の7項目すべてを収める。**センチメント別頻出語比較で`keywords.sentiment_word_comparison`に`all_negative_posts`(ネガ投稿が100件未満のときの代替出力)が入っている場合は、注記だけで済ませず全件を表として出力する(表の行数=`len(all_negative_posts)`)。4群分類は各群の語数を示し、3語未満の群についてはA-1が保存した理由の注記もそのまま表示する**
5. トピック別集計:`topics`のトピック件数表と、トピック×センチメントのクロス集計(ヒートマップまたは色分け表)の両方
6. 投稿者プロファイル:`profiles`の属性・影響力層・地域・アクティブ度(判明分/推定値を並記)。**判明率20%未満の属性(`profiles`側で信頼度「低」・参考値フラグが付いている属性。実測では地域の判明率が17%前後になるケースがある)は、判明分の実数を主として表示し、按分した推定構成比は「参考値(判明率X%)」と明記して併記する。推定値だけを大きく見せる表示にしてはならない。判明率5%未満で推定値が保存されていない属性は、判明分の実数と判明率だけを表示する**
7. 注目すべきクチコミ:`notable_posts`の一覧(フォロワー1万以上、センチメント付き、原文抜粋)
8. 推奨・紹介投稿の分析:`recommend_posts`の一覧
9. 時系列:`timeseries`の日別または月別の投稿数×センチメント推移、スパイク日の要因投稿
10. データ品質の注記:`data_quality`の全項目(判明率・按分の信頼度・使用辞書/閾値・投稿URL実在検証の3数値・外部要因セクション)。**使用辞書はポジティブ評価語・ネガティブ評価語の全語を省略せずに列挙し、bot判定・推奨判定の閾値、辞書の版番号(`dictionary_version`。保存されていない場合は「入力データ不足:辞書の版番号」と明記する)と、A-1が辞書を見直している場合は見直し前後の構成比も併記する。投稿URL実在検証は3数値に加え、A-1が保存した検証対象URL一覧(`verified_urls`)の件数と一致しているかを示す。A-1が「引用文の本文中に含まれていたURL数(検証対象外)」を保存している場合は、その件数と対象外にした理由も併記する(引用文中のURLは投稿本文の一部で、CSVの「投稿URL」列とは定義が異なるため突合対象にしない)。判定不能が0件または母数に対して著しく少ない(目安:1,000件超で0〜数件)場合は、A-1が保存した理由の注記をそのまま表示する(理由が保存されていない場合は「入力データ不足:判定不能が少ない理由(プロンプトA-1を再実行してください)」と明記する)**
11. マーケ・営業示唆:`marketing_suggestions`のペルソナ2〜3個、施策(今すぐ/中長期)
12. 問題点の指摘:`issues`の全件、各【問題】【根拠(具体数値)】【深刻度:高/中/低】【放置した場合の影響】付き
13. アクションプラン:`action_plan`の全件を8列の表で配置し、冒頭にクイックウィン3件を強調

# 出力直前チェック(アサーション必須)
HTML出力の直前に、次のすべてをコードでアサーションチェックし、1つでも満たさない場合はセクションを追加・修正してから出力する(理由の説明だけで済ませて出力することを禁止する)。
- 上記1〜13の全セクション見出しと、関連キーワード分析の7項目、および時系列セクションが、生成したHTML文字列中に実際に存在する
- 関連キーワードtop30セクションに描画された行(バー)の数が `len(data["keywords"]["top30"])` と一致する
- センチメント分析セクションに、全体構成比・投稿形式別・純クチコミのみの3種類の表がすべて存在し、各表が4区分を含む
- トピック件数表とトピック×センチメントのクロス集計の両方のセクションが存在する
- 投稿者プロファイルセクションに、属性・影響力層・地域・アクティブ度の4種類の表が存在する。判明率20%未満の属性には「参考値(判明率X%)」の注記が表示され、判明分の実数が主として表示されている
- 問題点の指摘セクションの件数が `len(data["issues"])` と一致する
- アクションプランセクションの表の行数が `len(data["action_plan"])` と一致し、8列すべてが表示されている
- マーケ・営業示唆セクションのペルソナ数が `len(data["marketing_suggestions"]["personas"])` と一致する
- データ品質の注記セクションに、`data_quality`内の「検証した投稿URLの総数」「CSVと一致した件数」「除外・差し替えた件数」の3つの数値がそのまま表示されている
- HTML内の`<svg`の出現数が4個以上あり、①キーワードtop30の横バー ②センチメント全体構成比の円または帯 ③クチコミ種別8区分の横棒 ④時系列の折れ線または棒 の4つがすべてSVGで描かれている(`div`の幅指定だけでグラフを代替していない)
- クチコミ種別8区分の件数表が存在し、その行数が8である(該当0件の区分も行として残っている)。無関係(同名誤検知)の「候補N件→確定M件」の表記と、純クチコミの除外定義式・除外件数の内訳がHTML内に文字列として存在する
- `keywords.sentiment_word_comparison`に`all_negative_posts`がある場合、その一覧表の行数が `len(all_negative_posts)` と一致する
- データ品質の注記セクションに、`data_quality`に保存されたポジティブ評価語・ネガティブ評価語の全語が表示されている
- HTML内に登場するすべての投稿URLが、入力JSON内の文字列と完全一致する(ドメインの書き換え・新規作成が0件。`twitter.com`を`x.com`に直す、末尾に`/photo/1`を足すといった整形も一致しなくなるため禁止)
- **【未展開のテンプレート文字列の残存禁止】HTML本文(`<style>`内のCSSを除いた表示テキスト)に、Pythonのコードの断片がそのまま残っていない。`{`と`}`で囲まれた式、`join(`、`.format(`、`f"`、`row[`、`data[` などの文字列をHTML全文から検索し、1件でも見つかったらf-string化漏れなので、その箇所を実際の値に展開してから出力する(実測で、4群分類の箇所に `{", ".join(grp["【競合・他サービス名】"])}` がそのままHTMLに出力された事例がある)**
- **HTML内の投稿URL(引用の根拠として掲載したもの)のユニーク件数をコードで数え、`data_quality`の「検証した投稿URLの総数」と一致する。一致しない場合は、A-1が検証していないURLを掲載しているか、入力JSONにないURLを追加していることになるので、差分を洗い出して削除・差し替えてから出力する(実測で、自己申告の「検証117件」に対してHTML内のユニークURLが134件あり、うち5件はCSVに存在しないURLだった事例がある)**
- **`data_quality`の辞書の版番号(`dictionary_version`)をそのまま表示している。A-1が`dictionary_revision`(辞書の変更記録)を保存している場合は、変更前後の構成比と追加語の全件も併記する**
- 時系列セクションの行数が `len(data["timeseries"]["data"])` と一致し、件数0の期間も行として残っている

# 制約
- 個人を特定・名指ししない(原文引用時はアカウント名を伏せる。これは入力JSON側で既に対応されているはずだが、この工程でも新たに個人を特定する情報を追加しない)
- 入力JSONにない数値・カテゴリ・引用文・URLを作成しない。値が見つからない場合は当該項目を「入力データ不足」と明記し、空欄のまま出力しない
- **自社公式アカウント(`meta`に記載の自社アカウントのユーザー名)の投稿は分析対象外なので、代表投稿・引用として表示しない。入力JSONに混じっていた場合はその項目を除外し、除外した件数をデータ品質の注記に記載する(実測で、自社公式アカウントの投稿URLが引用に混入した事例がある)**
- 入力JSON内の推定値フラグ(按分・推定であることの明示)は、HTML上でも「推定値」「※不明を判明分の比率で按分」等の注記として維持する。推定値を実測値のように断定表示してはならない。特に判明率20%未満の属性は「参考値(判明率X%)」と併記し、判明分の実数を主たる数値として扱う
- 出力するHTMLの見出し・本文は日本語(常用漢字)で統一する。簡体字・繁体字を混在させない
- 成果物は単一HTMLファイルとして完結させる
HTMLをダウンロードしてブラウザで開くと、クチコミ分析のレポートが一目で確認できます。
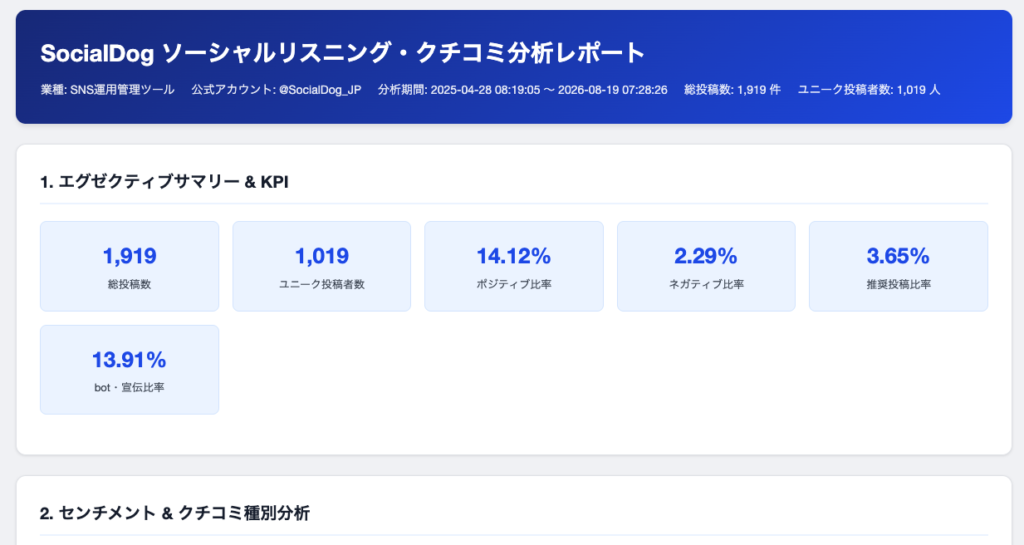
レポートには、主に次の内容が含まれます。
- エグゼクティブサマリー/KPIカード(総投稿数・ユニーク投稿者数・ポジ比率・ネガ比率・推奨投稿比率など)
- センチメント分析(全体/単独投稿とリプライの別/宣伝・botを除いた純クチコミのみ)
- クチコミ種別(感想・要望・質問・推奨・比較検討・宣伝・bot・無関係)
- 関連キーワード分析(頻出語Top30、ポジ・ネガ別の頻出語比較、共起ワード、競合名の言及)
- トピック別集計(どのテーマで不満が出ているかのヒートマップ)
- 投稿者プロファイル(属性・影響力・地域・アクティブ度)
- 注目すべきクチコミ/推奨・紹介投稿の分析(商談で使える生の声)
- 問題点の指摘とアクションプラン(優先度付き)
単一ページで完結しているため、そのまま社内共有や商談資料として活用できます。「どんな人が、どんな言葉で自社を語っているか」が言語化されるので、コンテンツのテーマ選びや広告コピー、ヘルプの文言づくりの起点としても使えます。
4. 運用する際に気をつけたいポイント
プロンプトはかなり細かくルールを書き込んでいますが、AIが出した結果をそのまま鵜呑みにするのはおすすめしません。実際に使う際は、次の点を確認してください。
- ①の実行後に表示される検算結果を確認し、エラーや未達項目がある場合は、そのまま②へ進まず①を再実行する
- 投稿者の属性・地域はプロフィールからの「推定値」であることを理解し、断定的な結論には使わない
- 「不明」を按分した推定値と、実測値を混同しない。判明率が低い属性は参考値として扱う
- ブランド名が一般名詞や他社名と重なる場合、無関係な投稿(同名誤検知)が混ざる。レポートの候補件数・確定件数を確認し、多い場合はキーワードモニターの条件を見直す
- キーワードモニターのCSVファイルにある「いいね」列は投稿者の累計いいね数であり、その投稿が獲得したいいね数ではない。インプレッションやリポスト数も含まれないため、拡散量はこのデータでは測れない(拡散を見たい場合は「クチコミがどれだけ届いたかを分析する(拡散・リーチ編)」へ)
- 個人を特定するような使い方はせず、集計・傾向として扱う
5. まとめ
SocialDogの「キーワードモニター」でクチコミを集め、A-1とA-2の2つのプロンプトを順番に実行することで、これまで手作業では難しかったクチコミの可視化・分析が手軽にできるようになります。出力されるHTMLレポートは、「どんな声が上がっているか」の把握だけでなく、課題の発見から具体的なアクションプランまでを一気通貫でカバーするため、商談やマーケ施策の準備にそのまま活かせます。
さらに、そのクチコミがどれだけの人に届いたのかまで見たい場合は、「クチコミ推移」を使った記事とあわせて実施すると、クチコミ分析が一周します。
ぜひ参考にしてみてください。