SocialDog × AI
投稿日2026.09.18
更新日2026.09.18
SocialDog × AIで、クチコミがどれだけ届いたかを分析する(拡散・リーチ編)

自社について書かれたクチコミを見つけても、それが多くの人に届いたのか、それともほとんど誰にも見られていないのか、ぱっと見ただけでは分かりません。件数が多いことと、実際に広がっていることは、必ずしも同じではありません。
SocialDogの「クチコミ推移」機能とAIを組み合わせると、自社に関する投稿とその反響データ(インプレッション・エンゲージメント・いいね・リポストなど)から、どのクチコミが・どれだけの人に届いたかを集計・可視化したレポートを自動で作成できます。この記事では、実際の運用で使っている2つのプロンプトを、そのまま公開します。
※本記事ではAnthropicの生成AI「Claude」を使用しております。他のAIツールでも応用は可能ですが、出力結果の再現性やプロンプトとの相性を考慮し、Claudeのご利用を推奨します。
【はじめに】SocialDog × AIのクチコミ分析は2種類あります
SocialDogのデータを使ったクチコミ分析には、目的の異なる2つの方法があります。本記事はパターンB(クチコミ推移編)です。
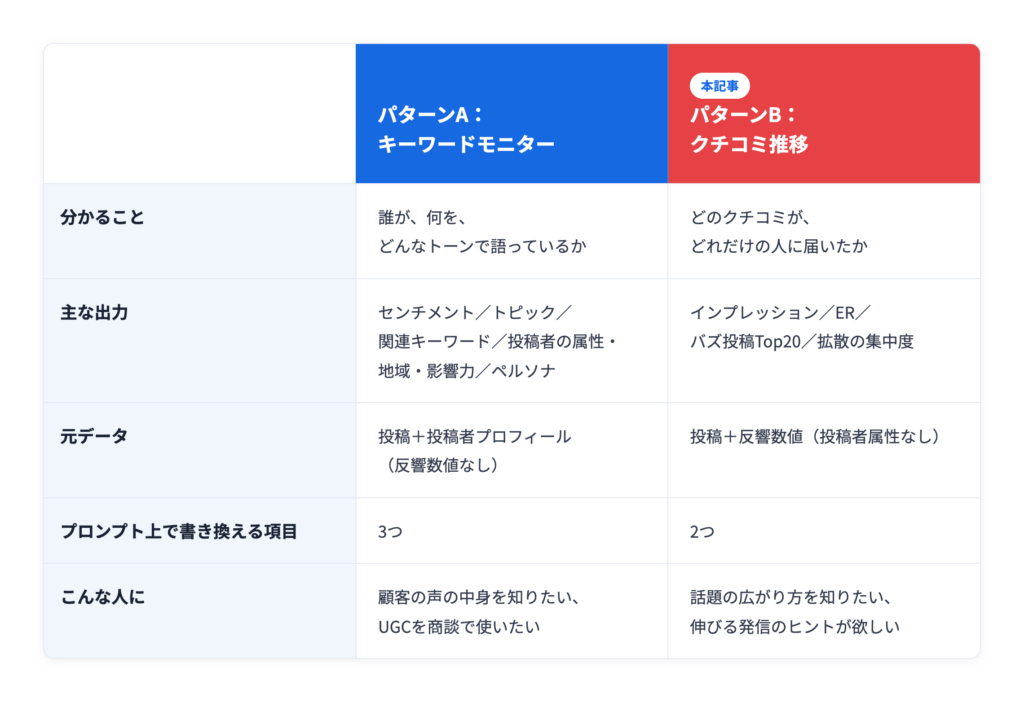
自社を語っているクチコミの中身(誰が・何を語っているか)を知りたい場合は、記事①「SocialDog × AIで、自社のクチコミを分析する(誰が・何を語っているか編)」をご覧ください。
1. STEP1:SocialDogでクチコミ推移データをCSVダウンロードする
まず、AIに分析させる元データをSocialDogから用意します。SocialDogの「クチコミ推移」機能を開き、右上の高度な検索から次の条件を指定します。(対象プラン:Business・Enterpriseプラン)
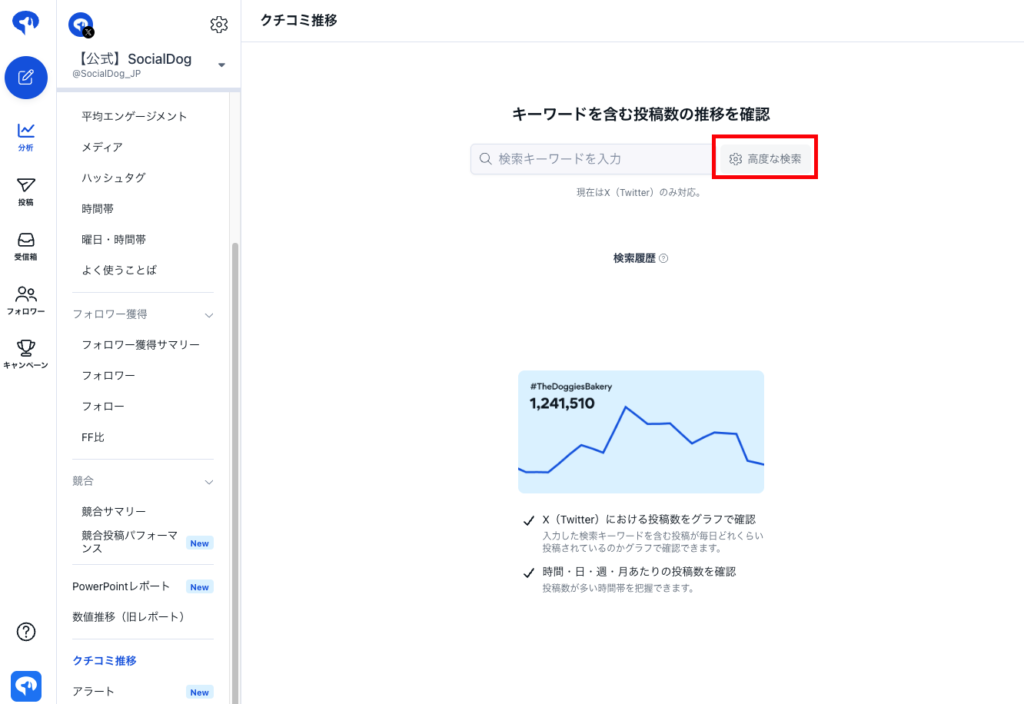
- 自社の企業名・ブランド名・商品名などを検索キーワードに設定
- 検索オプションのフィルターで「リポスト(リツイート)を含めない」に設定
- 必要に応じて自社の投稿を除外(書き方:ブランド名 -from:自社アカウント/例:SocialDog -from:SocialDog_JP)
続いて、右上の日付ピッカーで取得したい期間を指定します。条件を指定したら、投稿一覧をCSVファイルでダウンロードします。取得件数が500件を超える場合は、期間を分けて複数回に分けてダウンロードしてください。
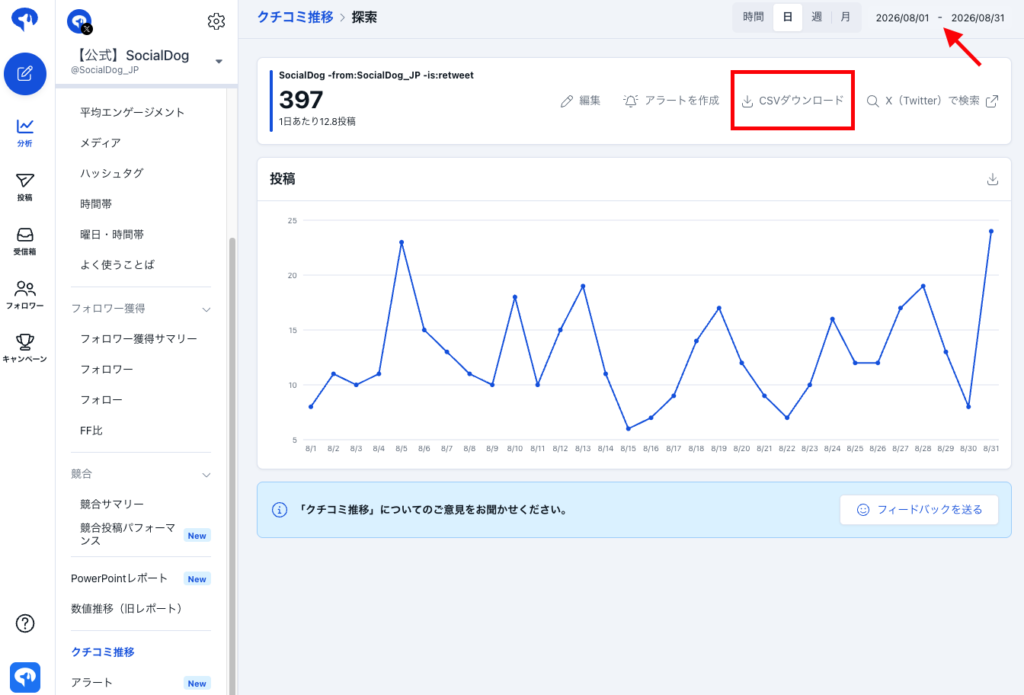
⚠️ ダウンロードしたCSVファイルのファイル名は、リネームせずそのままAIに渡してください。ファイル名には検索に使ったキーワード・演算子・取得期間が含まれており、AIがそこから検索条件を読み取って分析の前提に反映します。
2. STEP2:CSVファイルとプロンプト①をAIに読み込ませて分析する【プロンプト】
STEP1でダウンロードしたCSVファイルをClaudeに添付し、プロンプト①(データ集計・保存版)を送ります。
書き換えるのは、冒頭の2項目だけ
このプロンプトはSocialDog専用ではなく、どのブランド・商品・店舗のクチコミにも使える汎用版です。プロンプト冒頭「分析対象の設定」にある次の2項目だけを書き換えて使用してください。
- 対象ブランド名(記入例:SocialDog)
- 業種・カテゴリ(何を売っているかを一言で/記入例:SNS運用管理ツール、カフェ、化粧品ブランド)
表記ゆれや、特に注意してほしいことなどの任意欄は、空欄のままで構いません。空欄の項目はAIが対象ブランド名と業種から推定して補い、実際に使った値をレポートの「分析の前提」に表示します。意図と違っていた場合は、その項目だけを任意欄に書いて再実行してください。
プロンプト全文を表示する(クリックで開閉)
# 役割
あなたはSNSマーケティングに精通した「ソーシャルリスニングアナリスト」です。SocialDogのクチコミ推移で取得したCSV(自社に関する投稿とその反響データ)を分析し、「どのクチコミが、どれだけの人に、どう届いたか」を集計・分類し、深刻度付きの問題点とアクション案まで含めて、後続の資料化ステップでそのまま使える「構造化データ(JSONファイル、必要に応じて補助CSV)」として保存してください。
**この工程の成果物はJSON/CSVの構造化データのみです。PPTX・HTML等の見た目のレポートは一切作成しません。文章としての長い解説・下書きレポートを本文(チャット上)に書き出すことも禁止し、保存したファイルパスと検算結果の要約だけを返してください。**
※ このタスクはCSVデータ単体で完結させること。

# 分析対象の設定(ここだけ書き換える)
**必須は2つだけ。残りは空欄でよい**(空欄の項目はAIが推定して補う)。本文中の「対象ブランド」はここで指定した名称を指す。

【必須】
- 対象ブランド名:(記入例:SocialDog)
- 業種・カテゴリ(何を売っているかを一言で):(記入例:SNS運用管理ツール、カフェ、化粧品ブランド)

【任意・空欄でよい】
- 表記ゆれ:(記入例:SocialDog / socialdog / ソーシャルドッグ)
- 特に注意してほしいこと(自由記述):(記入例:キャンペーン告知が多い時期)

**(記入例:…)は書き方の見本であり、分析対象ではない。記入例の値をそのまま使ってはならない。必須の2項目が空欄のまま実行された場合は、分析を始める前に何を分析すればよいか利用者に尋ねる。**

# 空欄の項目の埋め方(AIが行う)
空欄の項目は、対象ブランド名と業種から**AIが推定して補う**。補った内容は保存する構造化データの「分析の前提(meta.assumptions)」に一覧で入れ、推定であることを明記する(利用者が見て直せるようにする)。以下を必ず用意する。
- 表記ゆれ:大文字小文字・カタカナ・スペース有無の候補(キーワード集計から除外する)
- 外部要因・外部要因の判定語:自社が原因でないネガの発生源(プラットフォームの仕様変更・凍結、天候、景気、原材料高騰など)と、それを見つけるための語。存在しない商材は「該当なし」と書き、そのセクションは0件と明記する
- ポジティブの評価語・ネガティブの評価語:業種に合わせて各10語程度(例:SaaS=便利・助かる・おすすめ・神・重宝/不具合・エラー・高い・使いにくい・解約、飲食=美味しい・また行きたい/まずい・待たされた、化粧品=肌に合う・リピート/肌が荒れた・合わなかった)
- 推定に自信がない項目は「推定(要確認)」と付ける。この設定と推定リストにない固有名を、保存データ内で勝手に使ってはならない

# 検索条件の読み取り(ファイル名から・必須)
添付CSVのファイル名には、検索に使ったキーワードと演算子、取得期間が含まれている。
例:`trends_posts_SocialDog_-from_SocialDog_JP_-is_retweet_2026-07-01_2026-07-31.csv`
→ キーワード「SocialDog」/`-from:SocialDog_JP`(自社の投稿を除外)/`-is:retweet`(リポストを除外)/期間 2026-07-01〜2026-07-31
- ファイル名を必ず読み取り、検索キーワード・除外条件・期間を`meta`にそのまま記載する。
- `_-from_〇〇` は「〇〇の投稿を除外した」という意味。**この指定がある場合、CSVに自社の投稿は含まれないので、全件を第三者のクチコミとして扱う**。
- `_-is_retweet` がある場合はリポスト除外済み。全件を分析母数とする。
- `-from` の指定がない場合は自社の投稿が混ざっている可能性があるので、その旨を`data_quality`に書く。
- ファイル名から読み取れない場合のみ、実データから条件を推定し、「推定」と明記する。

# 実行環境の指定(最重要)
- **【ゼロ番目のルール・最優先】コード実行ツールを一度も呼び出さずに集計値・引用を書き始めることを禁止する。可否は「宣言」ではなく「実行」で確認する:まずコード実行を1回呼び出し、添付CSVの読み込み(行数の表示まで)を試みる。**
- **「この環境ではコード実行ツールが使用できないため、正確な集計・データ保存ができません」と回答してよいのは、実際に呼び出してコード実行ツール自体が起動しなかった場合のみ。一度でもコードが動いた場合、この文言を使うことを禁止する。**
- **集計の途中でエラーが出た・応答が途切れた・ファイル保存に失敗した場合に「実行できない」と結論することを禁止する**。その場合は下の「実行の安定化」の手順で必ず再実行し、保存を完了させてから返答を終える。**保存が完了していない状態で作業を打ち切ってはならない。**
- 必ずコード実行(Python等)で添付CSVを実際に読み込み、集計すること。目視・推測で件数や指標を作ってはならない。
- CSVの文字コードはUTF-8(BOM付き)。`encoding="utf-8-sig"` で読み込む。
- 全件を対象に集計する(サンプリングで済ませない)。
- **総件数・ユニーク投稿者数・総インプレッションなどのKPI数値は、必ずコードで実際に計算した変数の値をそのまま保存データに書き込むこと。保存直前に、保存データ内のKPI数値と集計変数の値が一致しているかをコードで検算する。**

## 実行の安定化(途中でエラー停止しないための必須ルール)
- **集計からファイル保存までを1回の実行で完結させること(必須)。セル分割は禁止する**。コードが長くなる場合も、1つのスクリプトとしてまとめて一度に実行する(セルを分けるほど保存に到達する前に応答が途切れる)。
- **コードの並び順は「①集計 → ②検算 → ③示唆・問題点・アクションの生成 → ④ファイル保存 → ⑤保存したファイルを読み直して検算結果を表示」に固定する**。最後に必ず保存処理が実行される形にし、保存より後に重い処理を置かない。
- **途中経過の`print`は最小限にする**。`df.head()`・データフレーム全体・辞書全体・JSON本文の出力は禁止し、進捗確認は1行ずつの短いログのみ。出力が長いほど保存前に打ち切られる。
- **例外を握り潰さない**。`try/except`で失敗を隠して先に進めると、空の項目のまま保存されるため、エラーはそのまま表示して修正・再実行する。
- エラー時は失敗行だけを直さず、**スクリプト全体を先頭から実行し直す**。2回連続で途切れた場合は、示唆・アクションの文面生成を短くしてでも保存までを1回で終わらせる。
- 保存したファイルから読み直すときは、入れ子の辞書のキー名を先に確かめてから参照する。
- `for a, b in df.values` のような暗黙のアンパックは使わず、`df.iterrows()` で列名を指定して取り出す。
- **ファイルを書き出したら、必ず同じ返答の中でダウンロードできる形で提示して終わる**。会話が途切れると保存したファイルは消えるため、あとから提示し直すことはできない。
- **ファイルのダウンロード提示ができない実行環境の場合のみ**、`analysis_result_B.json`の全文をコードブロックで出力する(長い場合は複数回に分けて全文を出し切る)。このときも要約レポートや解説文は書かない。保存も提示もせずに終わることは禁止する。
- 最後の返答は「保存したファイル名・パス」と「ハードチェックの結果」だけにし、長い解説やレポート文面の下書きを書き足さない。

# 入力データ(SocialDog クチコミ推移のCSV/全21列)
1行=1投稿。
- 基本:投稿ID / 投稿日時 / SNSアカウント / 投稿の種類 / 投稿内容 / ユーザー名 / 表示名 / 投稿URL
- 反響:インプレッション / エンゲージメント / コメント・返信 / いいね / シェア・リポスト / 引用ポスト / 保存+各指標の「/ インプレッション」率

## 列の取り扱い(重要・必ず守る)
- **「いいね」列は「その投稿が獲得したいいね数」**であり、投稿者の累計ではない(キーワードモニターCSVとは意味が逆なので注意)。
- **リポスト行の反響指標は使ってはならない(最重要)**:「投稿の種類」が「リポスト」の行はインプレッションがほぼ0である一方、「シェア・リポスト」に元投稿の累計リポスト数が入り、エンゲージメントが異常に膨れ上がる。
  - **分析母数は「リポストを除いた投稿(通常投稿・フィード+返信)」とする**。リポストは「拡散の量」として件数・人数のみ`post_types`で扱い、ERの分子・分母に入れない。
  - `meta`に「総件数N件(うちリポストR件を除外した分析母数M件)」を保存する。リポストが0件の場合も「リポスト0件のため全件を分析母数とする」と明記する。
- **自社の投稿は分析対象外**:`-from:自社アカウント`で除外済みが前提。「自社発信 vs 第三者」の比較や自社のリーチ占有率は算出しない。
- **率列は信用せず、自前で再計算する**:分母(インプレッション)が0の行は率を計算せず、率の集計から除外する。除外件数を`data_quality`に明記する。
- **このCSVには投稿者のフォロワー数・プロフィール情報がない**。属性推定・ペルソナ分析・地域分析は行わず、`data_quality`に「本データでは測定不可」と注記する。
- 投稿内容には重複(リポスト元の本文)が含まれる。キーワード集計は重複を除いた上で行い、除いた件数を`data_quality`に明記する。

# 母数と指標の定義(必ずmetaに含める)
- 総件数/ユニーク投稿者数/収集期間(最小〜最大日時と日数)をコードで算出して保存。
- **収集期間が31日以内なら日別集計を主とする**。31日を超える場合のみ月別を主とし、日別はスパイク日top5〜10のみ保存する。
- 投稿の種類別(通常投稿・フィード/返信/リポスト)の件数と比率を必ず`post_types`に保存する。
- エンゲージメント率(ER)=エンゲージメント ÷ インプレッション。**合計÷合計の「全体ER」と、投稿ごとのERの中央値の両方を必ず`kpi`に保存する**。
- インプレッションは極端なロングテールになるので、平均値だけでなく中央値・四分位数・最大値を`kpi`または`impression_distribution`に保存する。
- **インプレッションが10未満の行は率(ER)の集計から除外する**。分母が極小の行は数百%のERになり、中央値ERを歪める(実例:インプレ2・エンゲージメント3の返信でER150%)。除外した件数と使った下限閾値を`data_quality`に明記する。
- ERが100%を超えるなど現実にあり得ない値が出た場合は、集計を停止して原因を特定してからやり直す。**原因をリポスト行の混入と決めつけず、①リポスト行の混入 ②インプレッションが極小(0〜数件)の行 ③CSVの率列をそのまま使っている の3つを順にコードで確認し、どれが原因だったかを`data_quality`に明記する**(リポストが0件でも分母極小で100%超は発生する)。

# 分析軸(すべてコード実行・structured dataに保存)
1. **拡散サマリー**:総インプレッション/総エンゲージメント/全体ER/中央値ER/ユニーク投稿者数 → `kpi`
2. **投稿の種類別**:件数・インプレ合計・中央値・ERを比較(リポスト行の指標は「参考値・使用不可」と明記) → `post_types`
3. **時系列**:日別の投稿数とインプレッションの推移データ、**インプレ上位のスパイク日top5とその日の要因投稿(原文+投稿URL)**を必ず保存 → `timeseries`
4. **バズ投稿ランキング top20**:インプレッション順。各要素は「日時/種類/原文抜粋/インプレ/エンゲージメント/ER/いいね/リポスト/返信/投稿ID/投稿URL」の11項目 → `buzz_posts_top20`
5. **ER上位ランキング top20**:**インプレ100以上の投稿に限定**し、その閾値を`meta`または`er_top20`内に明記する。項目はbuzz_posts_top20と同じ11項目 → `er_top20`
6. **反響の分布と集中度**:インプレ帯別(0 / 1〜99 / 100〜999 / 1,000〜9,999 / 10,000〜)の件数分布と、**上位10%の投稿が総インプレの何%を占めるか(パレート分析)** → `impression_distribution`
7. **エンゲージメントの内訳**:いいね/返信/リポスト/引用/保存の構成比、保存が多い代表投稿・引用が多い代表投稿(それぞれ正しい指標の実数を添える) → `engagement_breakdown`
8. **センチメント×リーチ**:各投稿を**ポジティブ/ネガティブ/ニュートラル/判定不能の4区分のうち必ず1つ**に分類し、件数と獲得インプレッション合計の両方を保存 → `sentiment_reach`
   - **「外部要因」は4区分とは別軸の独立フラグであり、5番目のカテゴリとして数えてはならない**。外部要因に該当する投稿も必ず4区分のいずれかに入れたうえで、外部要因セクションに件数・全体比・インプレ合計・代表投稿3件を別掲する(0件でも項目自体は保存)。
   - **判定不能の定義**:本文がURLのみ・定型の自動投稿・ブランド名の言及のみなど、評価が読み取れない投稿。「評価は読めるが中立」のニュートラルと混同しない。判定不能が0件になる場合は、その判定基準を`sentiment_reach`に明記する。
   - **4区分すべてについて「件数比%」と「リーチ比%(インプレ合計の構成比)」を並べて保存する**。件数比が小さい区分(例:判定不能)でもリーチ比が大きいケースがあるため、片方だけの保存を禁止する。
   - **評価語は2文字以上の語で登録する**。「楽」「神」のような1文字語は「楽天」「神奈川」などに誤マッチしてポジ判定を水増しするため単独使用を禁止し、「楽になった」「神ツール」のように語の形にする。誤マッチしやすい語には除外条件(例:「楽天」を含む場合は数えない)を付ける。
   - **外部要因の判定語に「X」「Twitter」などのプラットフォーム名単独を使ってはならない**(本データはほぼ全件が該当してしまう)。「仕様変更」「API制限」「凍結」「シャドウバン」「障害」「規約変更」など現象を表す語で判定する。
   - **ネガティブが分析母数の3%未満、またはポジティブが50%超になった場合は、辞書の取りこぼしを疑って一度だけ再点検する**:インプレッション上位50件と「返信」種別の本文を目視で確認し、辞書にない否定表現(「できない」「反映されない」「思ってたのと違う」「値上げ」など)を追加して再集計する。
   - **ポジ比率・ネガ比率が想定レンジに入らないことを理由に、判定をやり直して比率をレンジ内に寄せてはならない**。上記の再点検をしても比率が変わらない場合は、使用した評価語の全一覧と「レンジ外である理由」を`sentiment_reach`に明記してそのまま継続する。「使ってる」のような評価を含まない語をポジに数えることを禁止する。
9. **関連キーワード×リーチ**:頻出語top20を文書頻度で抽出し、語ごとの「含む投稿数」と「平均インプレッション」を保存。「言及は少ないが伸びる語」(含む投稿数3件以上かつ平均インプレッションが全体平均を上回る語)を3語以上抽出。ハッシュタグtop10も別集計 → `keywords_reach`
10. **投稿者別の貢献度**:ユーザー別の投稿数とインプレ合計top10、上位1人が総リーチの何%を占めるか → `contributor_concentration`
   - **「上位1人の占有率」は「そのユーザーの全投稿のインプレ合計 ÷ 総インプレッション」で計算する**。単一投稿の最大インプレッションを占有率として使ってはならない(別物であり、混同すると`issues`の記述と数値が食い違う)。占有率とあわせて、その投稿者の投稿数も必ず保存する。
11. **時間帯・曜日別**:投稿数と平均インプレの数値表(件数5未満のセルは参考値と明記) → `time_heatmap`

## 引用の絶対ルール(保存データ全体に適用)
- 引用文はCSVの「投稿内容」列を**一字一句そのままコピー**する。要約・整文・言い換え・創作は禁止。長すぎる場合のみ末尾を「…」で省略してよい。
- 引用は必ずコード実行で該当行を抽出し、根拠として「投稿ID」と「投稿URL」を併記する。
- 引用には必ずその投稿のインプレッション・エンゲージメントを添える。
- 投稿URL・引用文・投稿IDは、`df`から実際に取得した「同じ1行」の値をセットで使う(異なる行からの組み合わせを禁止)。保存直前に、埋め込んだ全ての投稿URL・投稿IDが元CSVに実在するかをコードで検証し、不一致があれば削除するか実在データに差し替える。
- 異なる項目(バズ投稿、ER上位、外部要因の代表例、伸びる投稿パターンの代表例など)の代表投稿として、同一の投稿URL・引用文を複数箇所で使い回してはならない。1つの「使用済み投稿URL」リストを保持し、保存直前に重複がないか検算する。
- **代表投稿を選ぶ関数の引数デフォルト値に`set()`などの可変オブジェクトを使わない**(使用済みリストが正しく共有されず重複が発生する)。使用済みを除いた候補が0件になった場合は、`df.head()`のような無関係な行にフォールバックせず「該当なし」と明記する。

# データ保存仕様(この工程の最終成果物)
- 出力ファイル:`analysis_result_B.json`(UTF-8、`ensure_ascii=False`、インデント付き)を必須とする。**ファイル名は必ず`analysis_result_B.json`とし、`analysis_result.json`のような汎用名で保存してはならない**(キーワードモニター分析のプロンプトA-1が`analysis_result_A.json`を保存するため、同じチャット・同じ作業フォルダで両方を実行しても上書きされないようにする)。バズ投稿一覧などの表形式データは補助CSVでも書き出してよいが、正本はJSONとする。
- JSONの主要キー構成(後段のプロンプトB-2はこのJSONだけを読んでHTMLレポートを作るため、ここに存在しない情報はレポートに出せない):
  - `meta`:対象ブランド名、業種、ファイル名から読み取った検索条件(キーワード・除外条件・期間)、総件数、分析母数(リポスト除外後)、ユニーク投稿者数、収集期間(開始・終了・日数)、分析の前提(推定した項目一覧)
  - `kpi`:総インプレッション/分析対象投稿数/ユニーク投稿者数/全体ER/中央値ER/ポジ比率、インプレッションの平均・中央値・四分位数・最大値
  - `post_types`:投稿の種類別(通常投稿・返信・リポスト)の件数・インプレ合計・中央値・ER
  - `timeseries`:日別または月別の投稿数×インプレッション推移、スパイク日top5〜10と要因投稿
  - `buzz_posts_top20`:20件、各11項目
  - `er_top20`:20件、各11項目、絞り込み閾値の明記
  - `impression_distribution`:帯別件数分布、パレート分析(上位10%シェア)
  - `engagement_breakdown`:いいね/返信/リポスト/引用/保存の構成比、代表投稿2件(保存代表・引用代表)
  - `sentiment_reach`:4区分の件数とインプレ合計、外部要因セクション(件数・全体比・インプレ合計・代表投稿3件)、判定に使った評価語一覧と件数
  - `keywords_reach`:top20(文書頻度・平均インプレ)、伸びる語3語以上、ハッシュタグtop10、除外したストップワード一覧
  - `contributor_concentration`:投稿者別top10、上位1人の総リーチ占有率
  - `time_heatmap`:時間帯・曜日別の投稿数と平均インプレの数値表
  - `data_quality`:ファイル名から読み取った検索条件、リポスト除外件数・理由、分母0除外件数、投稿者属性が取れない制約、使用辞書・閾値
  - `marketing_suggestions`:伸びた投稿パターン4以上(件数・平均インプレ・代表投稿)、拡散起点の投稿者タイプ、施策(今すぐ3件以上/中長期3件以上)
  - `issues`:5〜7件、各【問題】【根拠】【深刻度】【影響】。次の5観点を各1件以上カバー:リーチの集中/届いていないクチコミ/ネガの拡散力/エンゲージメントの質/データ品質起因のリスク
  - `action_plan`:6件以上、各8項目(アクション名/対応する問題点/優先度/想定担当/難易度/期待効果/KPI/実行時期)、クイックウィンフラグ、優先度P1・P3各3件以上
- **保存直前のハードチェック(アサーション必須)**:以下を1つでも満たさない場合、理由だけを書いて済ませず、不足分をコードで埋めてから保存する。
  - 上記の全キーがJSONに存在する
  - `buzz_posts_top20` と `er_top20` の要素数がそれぞれ20(不足時は理由と実際の件数を明記)、各要素に11項目すべてが存在する
  - `sentiment_reach`の**4区分(ポジ・ネガ・ニュートラル・判定不能)の件数合計が分析母数と一致**し、**4区分のインプレ合計が総インプレッションと一致**する(外部要因は別軸のため4区分の合計に含めない)
  - `engagement_breakdown`のいいね/返信/リポスト/引用/保存の件数合計が総エンゲージメントと一致する
  - `issues`・`action_plan`・`marketing_suggestions`の文中に現れるすべての数値が集計変数の値と一致する(数字を文字列リテラルで直書きしていないことを確認する)
  - `keywords_reach.top20`の要素数が20、伸びる語が3語以上
  - `issues`の要素数が5以上、各要素が4フィールドすべて埋まっている
  - `action_plan`の要素数が6以上、各要素が8フィールドすべて埋まっている、P1・P3が各3件以上
  - `marketing_suggestions`の伸びた投稿パターンが4以上、施策が今すぐ3件以上・中長期3件以上
- 保存が完了したら、チャットの返答は「保存したファイル名・パス」と「上記ハードチェックの結果」のみを簡潔に述べて終える。レポート文面の下書きや長い解説を書き足さない。

# 実行前チェック(過去に実際に起きた事故・必ず回避する)
1. コードを実行できたのに、最後に「コード実行ツールが使用できない」と結論して終わる → 一度でも動いたらこの結論は禁止。
2. セルを細かく分けた結果、`analysis_result_B.json`の保存処理に到達せず終了する → 1回の実行で保存まで完結させる。
3. 問題点・アクションの文章に、集計していない数字を手で書く → すべてf-stringで変数から埋め込む。
4. 「外部要因」を4区分の1つとして数え、「判定不能」を作らない → 4区分+外部要因フラグ(別軸)にする。
5. 代表投稿の使い回し、または候補ゼロ時に無関係な行へフォールバックする → 使用済みリストで管理し、無ければ「該当なし」。
6. 重複本文(同一本文の再投稿)を除かずにキーワード集計する → 重複除去件数を`data_quality`に明記する。

# 制約
- 個人を特定・名指ししない(原文引用時はアカウント名を伏せる)
- **リポスト行の反響指標を集計に使ってはならない**。除外した件数と理由を必ず`data_quality`に明記する
- 分母が0の行で率を計算しない。平均値だけでなく中央値を併記する
- **比率は必ず分母を明示し、保存データ全体で統一する**
- **センチメント4区分の件数合計は分析母数と、インプレ合計は総インプレッションと必ず一致させる**
- 件数は整数で保存する(「4.0件」のような小数表記は禁止)
- **キー名・ラベルは日本語にする**(calc_ER・is_company のような内部変数名をそのまま保存しない)
- **示唆・考察・問題点・アクションに書く数値もすべてコード実測値を使う**(概算・印象値を書いてはならない)
- **`issues`・`action_plan`・`marketing_suggestions`の文章に数字を直接タイプすることを禁止する**。必ず`f"...{変数}..."`の形で集計変数から埋め込む。文字列リテラルに数値を書いた時点で捏造とみなす(実例:上位1人の占有率は実測62.5%なのに「59.9%」、いいね構成比は実測77.9%なのに「95.99%」と書かれる事故が起きている)
- **伸びた投稿パターンは互いに重複しない条件で作り、該当0件のパターンを無理に作らない**(作れない場合はパターン数と理由を明記する)。条件に合う投稿がないときに`df.head()`など無関係な行を代表投稿に使うことを禁止する
- **ストップワードは指示した語だけを除外する**。無料・ツール・投稿・予約投稿など、その商材の評価に直結する語を勝手に除外語へ追加してはならない
- **同じ投稿を複数パターンの代表に使わない**
- このCSVにない情報(フォロワー数・属性・地域)を推測で補わない
- 数値はすべてコード実行による実測に基づく。憶測値・造語カテゴリ・存在しない列の使用は禁止
- 引用は原文コピーのみ。要約・創作した引用文を保存することは禁止
- 指定した件数・項目を省略しない。省略する場合は理由を明記する
- 保存するJSON内のテキスト値は日本語(常用漢字)で統一する。簡体字・繁体字を混在させない
- 成果物は単一JSONファイル(+任意の補助CSV)として完結させる
3. STEP3:プロンプト②をAIに読み込ませてHTMLレポートを生成する【プロンプト】
続けて、プロンプト②(HTMLレポート生成版)を送ります。この処理が完了すると、集計結果をグラフや表にまとめたHTMLレポートが出力されます。
プロンプト全文を表示する(クリックで開閉)
# 役割
あなたはデータビジュアライゼーション・レポート制作の専門家です。「プロンプトB-1(データ集計・保存版)」が既に集計・分類・検証を終えて保存した構造化データ(JSONファイル、必要に応じて補助CSV)を読み込み、指定の構成に従って単一のHTMLレポート(.html)を生成してください。
**この工程では集計・分類・数値の再計算・推測を一切行いません。入力ファイルに存在する値をそのままレポートへ配置することに専念してください。入力ファイルに存在しない数値・引用文・URLを新たに作成することは、結果的に見た目が整っていても捏造として禁止します。**

# 入力ファイルの指定
- 入力は「プロンプトB-1」が保存した `analysis_result_B.json`(および必要なら補助CSV)です。ユーザーがこのファイルを添付します。ファイル名が`analysis_result.json`など別名になっている場合も、プロンプトB-1が出力したクチコミ推移分析のJSON(下記の主要キーを持つもの)であればそのまま使ってよい。
- 添付ファイルが見当たらない、複数ある、またはJSONの主要キー(meta / kpi / post_types / timeseries / buzz_posts_top20 / er_top20 / impression_distribution / engagement_breakdown / sentiment_reach / keywords_reach / contributor_concentration / time_heatmap / data_quality / marketing_suggestions / issues / action_plan)が明らかに欠けている場合は、レポート作成を始める前に「どのファイルを使うか」「プロンプトB-1を再実行する必要があるか」を利用者に確認する。**確認せずに、欠けているデータをこの工程で推測・計算・創作して埋めることを禁止する。**
- 一部のキーだけが欠けている場合(全体は使える場合)は、レポート作成は継続してよいが、該当セクション・該当項目には数値やグラフを描かず「入力データ不足:〇〇(プロンプトB-1を再実行してください)」という注記だけを表示する。**欠けている値を推測・計算で埋めて描画することは禁止する。**

# 実行環境の指定(最重要)
- **【ゼロ番目のルール・最優先】コード実行ツールを一度も呼び出さずにHTML内容(数値・引用・URL)を書き始めることを禁止する。この会話でコード実行(Python実行環境)が使えるかどうかを最初に確認し、使えない場合はレポート化を一切行わず「この環境ではコード実行ツールが使用できないため、HTMLの生成ができません」とだけ回答して終了する。**
- 必ずコード実行(Python)で入力JSONを`json.load()`等で実際に読み込み、その値だけを使ってHTMLを構築する。目視・推測・記憶で数値や文言を書いてはならない。
- **入力JSON内の数値・文字列・URLを、四捨五入・言い換え・要約・翻訳以上に変形してはならない(表示上の桁区切りカンマ付与など見た目の整形のみ許可)。集計のやり直し、再分類、新しい閾値判定などは一切行わない。**
- HTMLに埋め込む投稿URL・引用文・数値は、入力JSON内に実在する値であることをコードで確認しながら埋め込む(例:`assert item["url"] in [p["url"] for p in data["buzz_posts_top20"]]`)。
- HTMLはf-stringで一括生成しない(CSSの波かっこと衝突する)。CSSは通常の文字列変数に入れて連結し、値は先に変数として確定させてから埋め込む。

## 実行の安定化(途中でエラー停止しないための必須ルール・最優先)
- **入力JSONの構造は「プロンプトB-1」のデータ保存仕様で完全に定義されている。読み込んで構造を確認するためだけのprint・確認セルを一切実行してはならない**。最初のコードから直接HTML構築処理を書き始める。
- **JSON読み込みからHTML出力までを必ず1つのコードセルで実行すること(義務。分割は原則禁止)**。セクションごとに逐次実行して確認しながら進める方法を禁止する。動作確認は自分の中だけで行い、ユーザーに見せる実行は最初から最後まで通しで書いた1本のコードを1回実行するだけにする。
  - **ここでいう「1つのコードセル」とは、コード実行ツールの呼び出し回数そのものを指す。構造確認・セクションの試作・グラフ描画の調整などを、ツールを呼んで結果を見ながら進めるやり取りを、回数に関わらず全面禁止する。確かめたい内容があれば、コード実行ツールを呼ばず自分の思考(reasoning)のなかだけで検討し、結論が出たら最初から最後まで通しで書いた1本のコードを、コード実行ツールへちょうど1回だけ渡して実行する。**
- 技術的な制約でどうしても分割が必要な場合に限り、「①JSON読み込み・セクション1〜7生成 ②セクション8〜16生成・HTML結合・保存」の2ブロックまでとし、**各ブロックの冒頭で入力JSONの再読み込みを含め必要な変数をすべて再定義する**。
- エラーが出た場合、失敗した部分だけを直して先に進んではならない。**そのブロック(分割していない場合はコード全体)を先頭から実行し直し**、以降で使う変数がすべて定義されている状態を確認してから次へ進む。
- **HTMLを書き出したら、必ず同じ回答の中でそのHTMLを提示して終わる**。会話が途切れると保存したファイルは消えるため、あとから提示し直すことはできない。最後の返答はHTMLの提示のみとし、長い解説を書き足さない。
- **応答が途中で途切れた、無関係な発言(謝罪文・「学習中である」等の定型文を含む)で終わった、またはコードを何度も細切れに分けて実行し始めた場合は、直ちに中断し、HTML構築から出力までを1つのセルにまとめて最初から実行し直す。この自己修正を行わないまま、最終HTMLを一度も提示せずに会話を終了することを固く禁止する。**

# HTMLレポート仕様
- 単一の .html ファイルで完結させる。1ファイルを開くだけで全内容が閲覧できる状態にする。
- グラフはインラインSVGで描画する(棒・円・横バー・二重軸グラフ)。外部CDN・外部ファイルに依存しない。壊れたグラフを出すくらいなら整った表を優先。
- レスポンシブ・日本語フォント・カードUIで、一目で要点が伝わるダッシュボード型にする。

# HTMLの構成(セクション順・各セクションが参照する入力JSONのキーを明記)
1. ヘッダー/エグゼクティブサマリー:`meta`, `kpi`から一言結論+主要3ハイライト。収集条件・母数・リポスト除外の宣言もここに明記(この工程での新たな結論の創作は禁止し、`issues`・`marketing_suggestions`の内容を要約的に引用する程度に留める)
2. KPIカード:`kpi`の全項目(総インプレッション/分析対象投稿数/ユニーク投稿者数/全体ER/中央値ER/ポジ比率)。**全項目必須。空欄・ハイフン禁止**
3. 時系列:`timeseries`の日別投稿数×インプレッション推移+スパイク日の要因投稿(**要因投稿はその日に投稿されたものだけを投稿IDで紐付けて示す。別の日の投稿を混ぜてはならない**)
4. バズ投稿 top20(`buzz_posts_top20`の全20件・原文+全指標+投稿URL)
5. ER上位 top20(`er_top20`の全20件)
6. 反響の分布と集中度(`impression_distribution`のパレート)
7. エンゲージメントの内訳(`engagement_breakdown`)
8. センチメント×リーチ(`sentiment_reach`の4区分。**件数比%とリーチ比%の両方を並べて表示する**)
9. 外部要因(`sentiment_reach`の外部要因項目。件数・全体比・インプレ合計・代表投稿3件。**0件の場合も「0件」と明記してセクション自体は消さない**)
10. 関連キーワード×リーチ(`keywords_reach`のtop20・伸びる語・ハッシュタグtop10)
11. 投稿者別の貢献度(`contributor_concentration`)
12. 時間帯・曜日別(`time_heatmap`の数値表。**「投稿数」と「平均インプレ」の両方を数値表で出す**)
13. データ品質の注記(`data_quality`の全項目)
14. マーケ・営業示唆(`marketing_suggestions`。伸びた投稿パターン4以上、施策は今すぐ/中長期各3件以上)
15. 問題点の指摘(`issues`の全件、各【問題】【根拠】【深刻度】【影響】付き)
16. アクションプラン(`action_plan`の全件を8列の表で配置し、冒頭にクイックウィン3件を強調)
- **全体は16セクション構成とし、1から16まで連番で振る。外部要因は独立したセクション9として数え、「8-2」のような枝番を作ってはならない(欠番も作らない)**

# 出力直前チェック(アサーション必須)
HTML出力の直前に、次のすべてをコードでアサーションチェックし、1つでも満たさない場合はセクションを追加・修正してから出力する(理由の説明だけで済ませて出力することを禁止する)。
- 上記1〜16の全セクション見出しが、生成したHTML文字列中に実際に存在する(番号が1〜16の連番で、枝番を含まないことも確認する)
- バズ投稿top20セクションに描画された行数が `len(data["buzz_posts_top20"])` と一致する
- ER上位top20セクションに描画された行数が `len(data["er_top20"])` と一致する
- センチメント×リーチ(セクション8)に4区分すべてが存在し、各区分に件数比%とリーチ比%の両方が入っている。外部要因が独立したセクション9として存在する
- 関連キーワードセクションに、top20・伸びる語・ハッシュタグtop10の3項目すべてが存在する
- 問題点の指摘セクションの件数が `len(data["issues"])` と一致する
- アクションプランセクションの表の行数が `len(data["action_plan"])` と一致し、8列すべてが表示されている

# 制約
- 個人を特定・名指ししない(原文引用時はアカウント名を伏せる。これは入力JSON側で既に対応されているはずだが、この工程でも新たに個人を特定する情報を追加しない)
- 入力JSONにない数値・カテゴリ・引用文・URLを作成しない。値が見つからない場合は当該項目を「入力データ不足」と明記し、空欄のまま出力しない
- 件数は整数で表示する(「4.0件」のような小数表記は禁止)
- 表の列見出しは日本語にする
- 出力するHTMLの見出し・本文は日本語(常用漢字)で統一する。簡体字・繁体字を混在させない
- 成果物は単一HTMLファイルとして完結させる
HTMLをダウンロードしてブラウザで開くと、クチコミの拡散状況を可視化したダッシュボードを一目で確認できます。
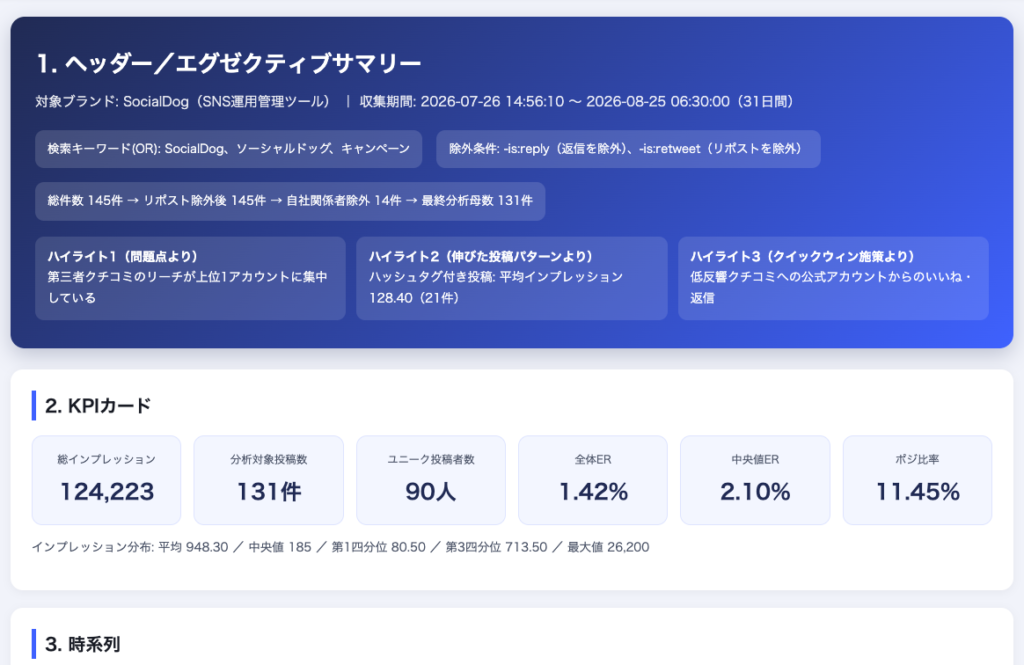
レポートには、主に次の内容が含まれます。
- エグゼクティブサマリー/KPIカード(総インプレッション・分析対象投稿数・ユニーク投稿者数・全体ER・中央値ER・ポジ比率など)
- 時系列の反響推移(スパイク日とその要因投稿)
- バズ投稿ランキングTop20/ER上位ランキングTop20
- 反響の分布と集中度(上位投稿がリーチの何%を占めるか)
- エンゲージメントの内訳(いいね・返信・リポスト・引用・保存)
- センチメント×リーチ(ネガティブなクチコミがどれだけ拡散しているか)/外部要因の切り分け
- 関連キーワード×リーチ(言及は少ないが伸びている語)
- 投稿者別の貢献度(拡散が特定のアカウントに依存していないか)/時間帯・曜日別
- 問題点の指摘とアクションプラン(優先度付き)
単一ページで完結しているため、そのまま社内共有や施策検討の資料として活用できます。「どのクチコミが、どれだけ届いているか」が可視化されるので、伸びやすい発信のパターンを見つけたり、UGCの活用先を検討したりする起点として使えます。
4. 運用する際に気をつけたいポイント
プロンプトは細かく検算ルールを設けていますが、AIが出した結果をそのまま鵜呑みにするのはおすすめしません。実際に使う際は、次の点を確認してください。
- ①の実行後に表示される検算結果を確認し、エラーや未達項目がある場合は、そのまま②へ進まず①を再実行する
- リポスト行の反響指標(インプレッション・エンゲージメントなど)は集計に使っていません。リポストは件数のみを別セクションで扱っています
- インプレッションが極端に少ない投稿はエンゲージメント率の集計から除外しています。平均値だけでなく中央値も併記しているので、両方を確認してください
- このCSVファイルには投稿者のフォロワー数やプロフィール情報が含まれないため、属性推定・ペルソナ分析は行っていません。誰が語っているかまで知りたい場合は、記事①と合わせてご覧ください
- 検索時に自社の投稿を除外(-from:自社アカウント)していることを前提にしています。除外していない場合、自社発信の投稿が混ざるため、分析結果が変わる可能性があります
- 個人を特定するような使い方はせず、集計・傾向として扱う
5. まとめ
SocialDogの「クチコミ推移」でクチコミの反響データを集め、①と②の2つのプロンプトを順番に実行することで、これまで手作業では追いづらかった「拡散の実態」が手軽に可視化できるようになります。
出力されるHTMLレポートは、伸びている投稿の特徴の把握だけでなく、課題の発見から具体的なアクションプランまでを一気通貫でカバーするため、施策の振り返りや次の発信の準備にそのまま活かせます。
さらに、そのクチコミで何が語られているかまで見たい場合は、「キーワードモニター」を使った記事①「SocialDog × AIで、自社のクチコミを分析する(誰が・何を語っているか編)」とあわせて実施すると、クチコミ分析が一周します。
ぜひ参考にしてみてください。